音乐库补完计划:2.2 万首歌,怎么还是只听那几十首?我给 Navidrome 加了个声学引擎
2026-10-15
两个多月前写过一篇 Navidrome,我用它把硬盘里那几百个 G 的无损音乐,变成了一个能听的音乐库。
上篇的地址:https://mp.weixin.qq.com/s/zU56_A7RS7hMNVtHMXHLeQ
能听是一回事,听什么又是另一回事。
选歌
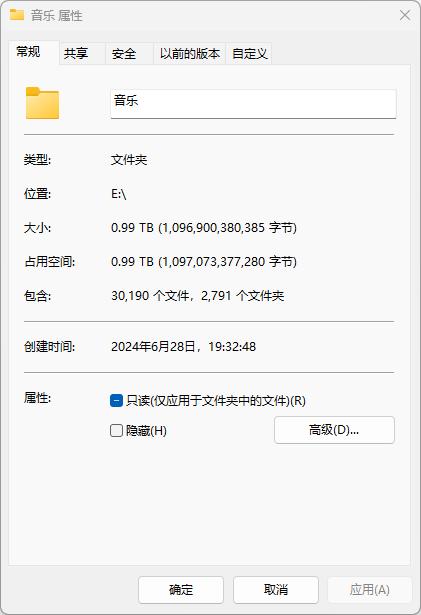
上次写那篇的时候,库是七百来个 G。现在快一个 T 了——三万个文件,两万两千首是音频。
我现在不缺歌了,但反而不知道听什么。打开播放器翻半天,最后还是点那几十首。
标签靠不住:不少歌没有流派标签。有标签的那些也不一定对,光日系流行就有 JPop、J-Pop、Jpop 三种写法,同一类东西被拆成三堆。顺着专辑和艺人翻,翻来翻去还是我熟悉的那几个名字。
我想要的是另一种推荐。
AudioMuse-AI 给的就是这一种:分析每首歌的音频,算出相似度,再把结果推给我。
原理
自建库也不是没有推荐。Navidrome 自带的 Instant Mix 接的是 Last.fm、Deezer 这类外部服务,依据是「别人在听什么」。
我试过,出来的东西不太对味:它串给你一批「同类型」,而不是「听起来像」。何况这个库里只有我一个听众,别人听了什么,跟我此刻想听什么,关系不大。
AudioMuse-AI 换了一套依据:不看别人听什么,直接分析声音本身。
每首歌先被解码成 16kHz 的单声道,切成一片一片,每片算一张梅尔频谱图:横轴是时间,纵轴是频率,颜色深浅是那个频率上的能量。下面这张就是它眼里的一首歌,竖线是切片的位置,每片约 3 秒。
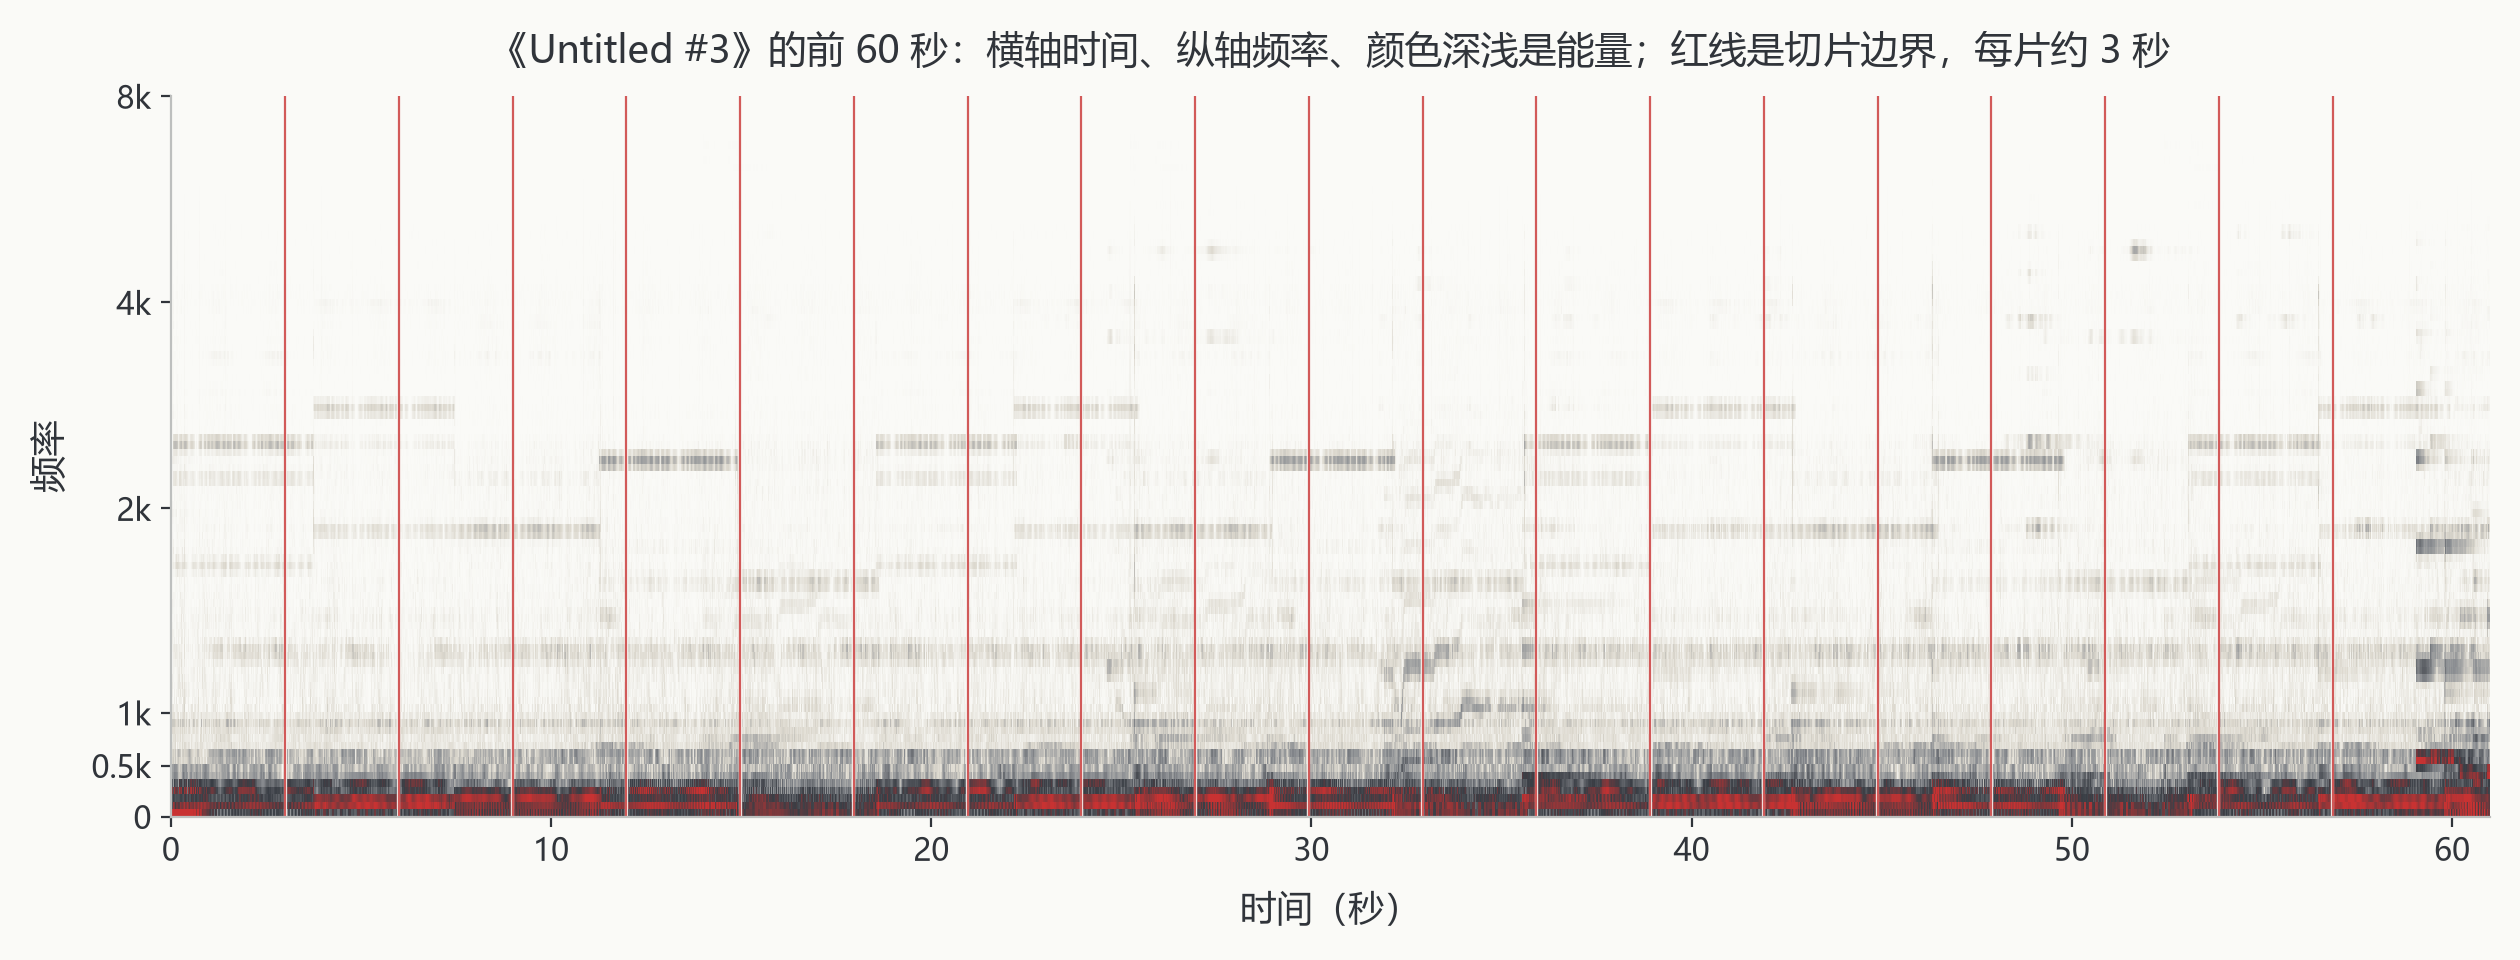
每片图交给模型换算成 200 个数字,代表这一小段声音的特征。一首歌所有片子的数字取平均,这首歌就变成了 200 个数字。
两首歌像不像,就看这两组数字差多少,差得越小,听起来越像。它给你推的歌,就是这么比出来的。
另一个模型负责给每首歌打分,50 个标签,jazz、ambient、chill、happy、sad 这些,歌单的命名和归类用的就是它。
自带的推荐,依据是别人在听什么。我想要的依据是:歌和歌之间像不像。
试跑
我把它装在自己电脑上,用的是官方 Windows 原生包,装完在浏览器里点几下就能走。
第一轮先拿最近入库的 25 张专辑试手,一共 164 首:松任谷由実的一串单曲、Sigur Rós 的《( )》,还有十几张 Philip Glass 的专辑。
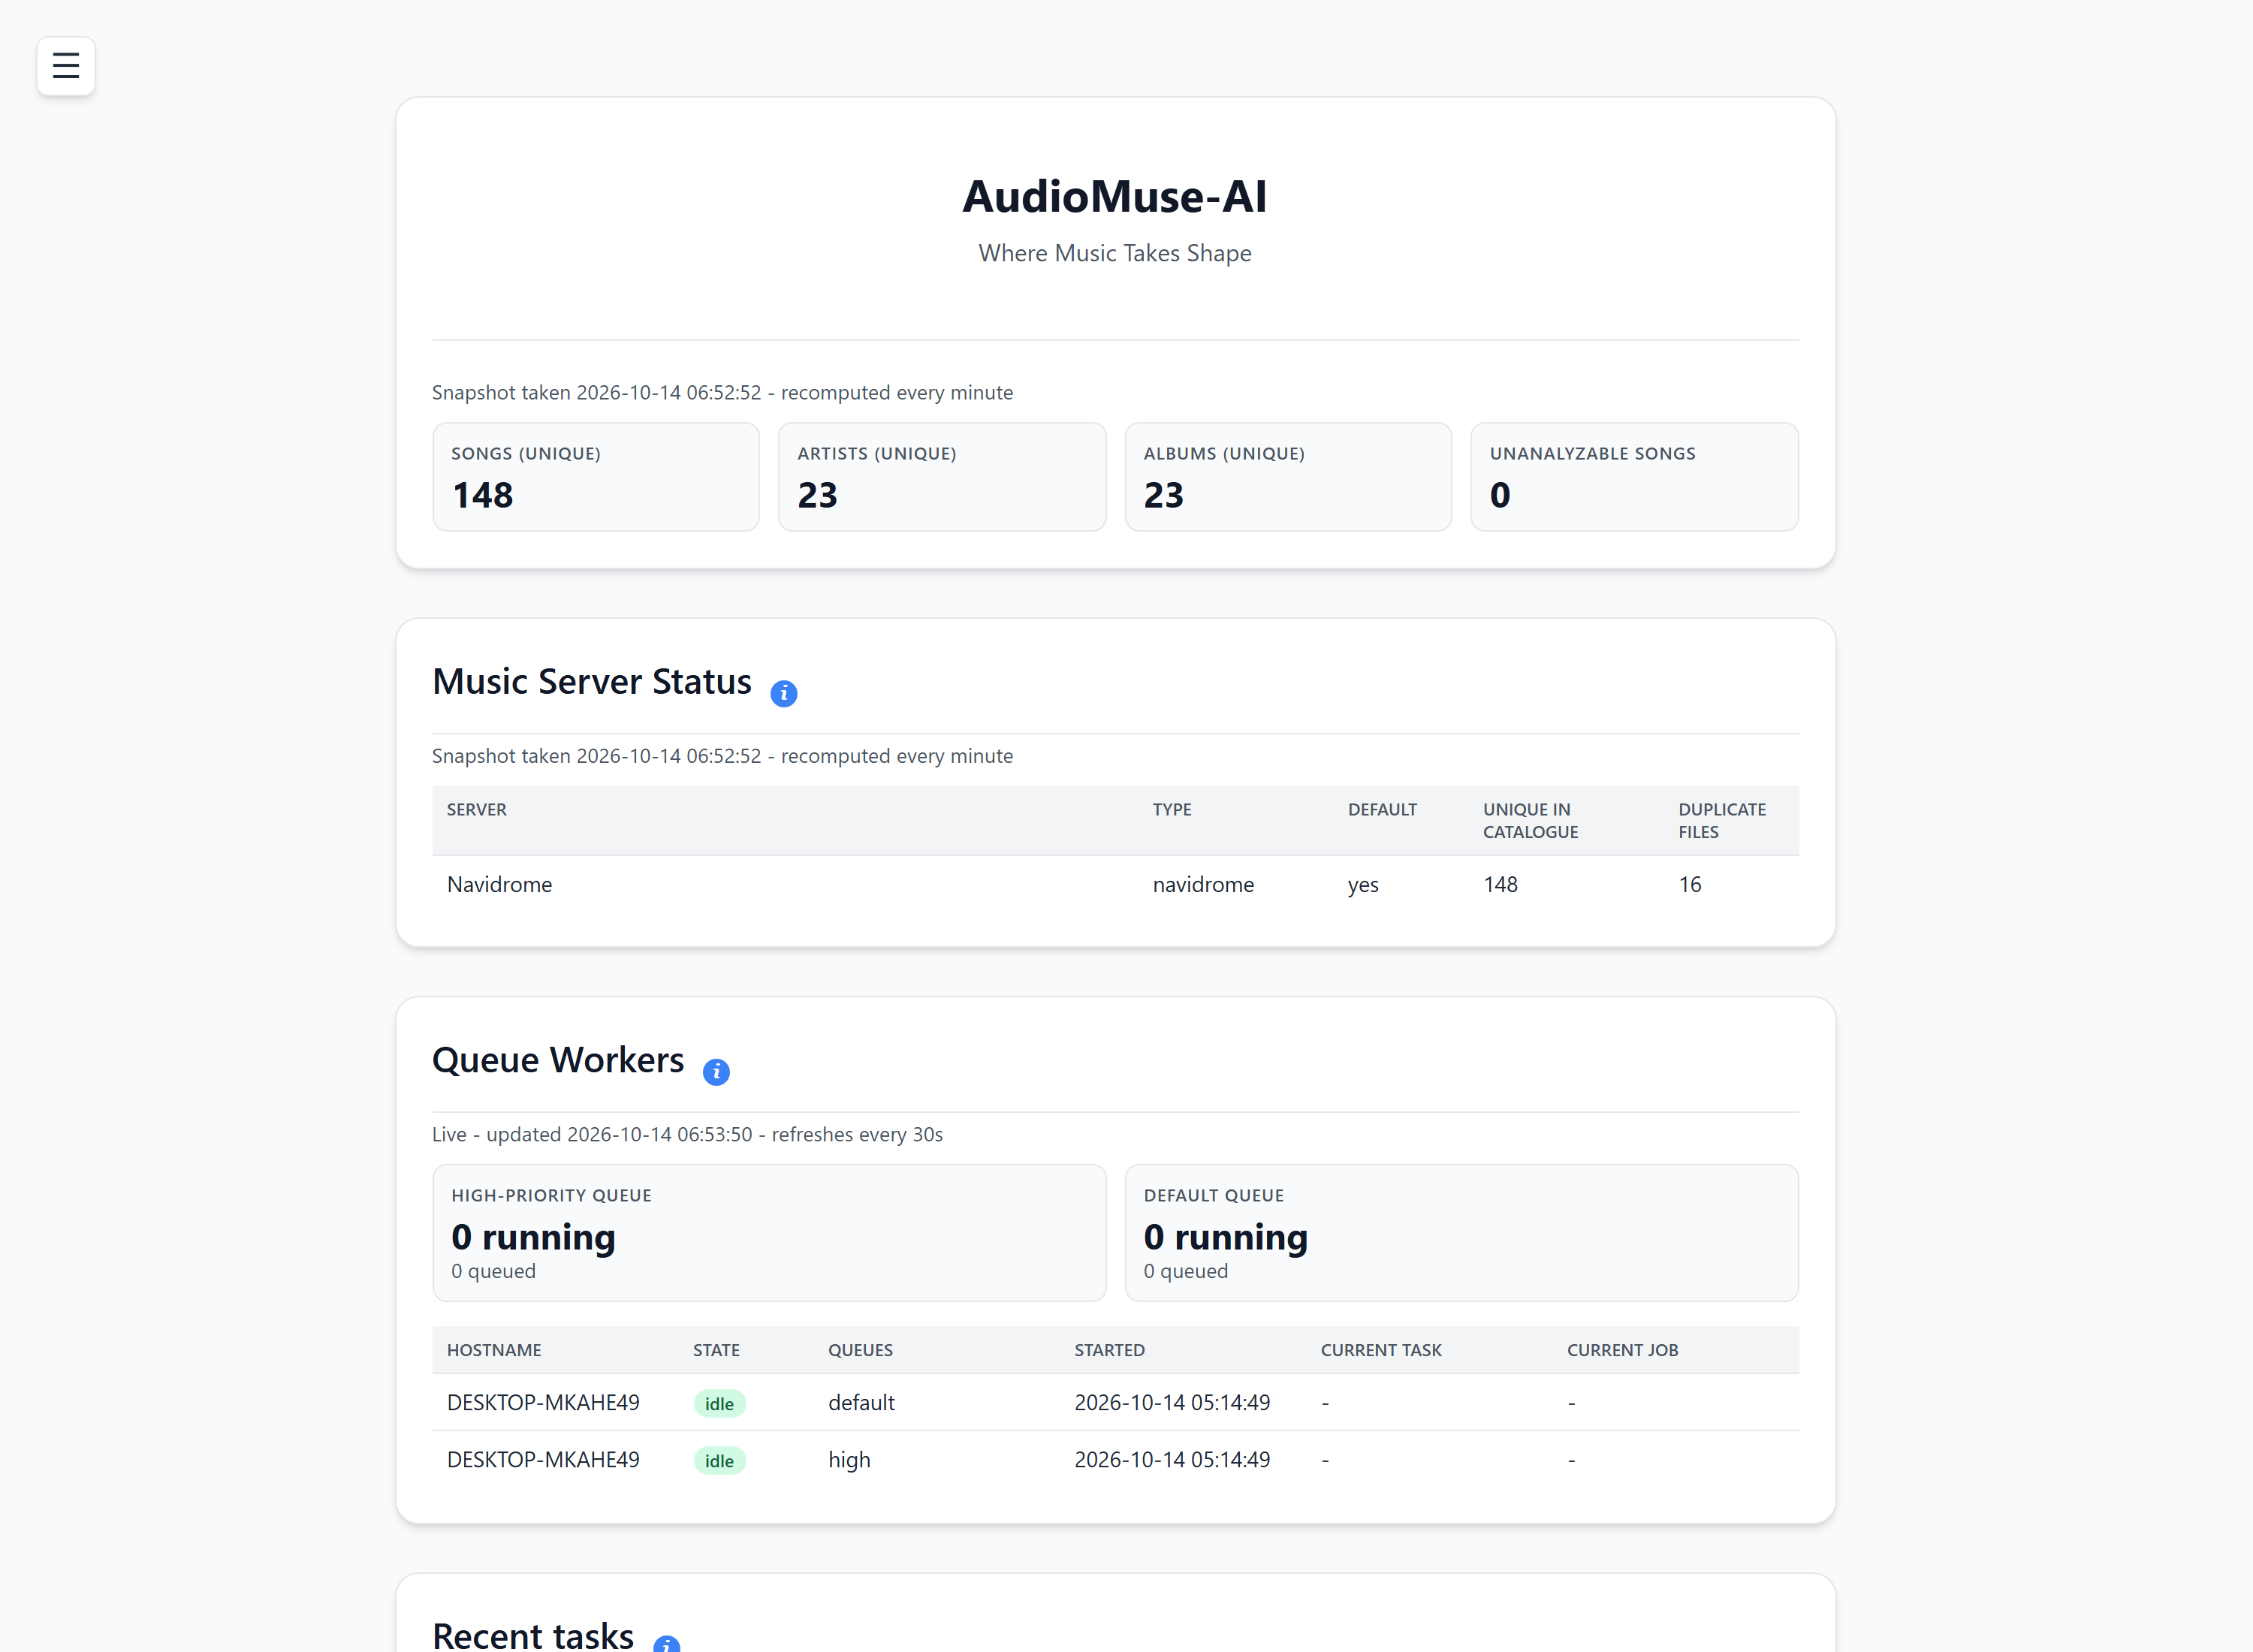
53 分钟跑完。这 53 分钟里它把每首歌从 Navidrome 拉下来,解码,算两套模型,顺带算一遍声纹。
Sigur Rós 的《Untitled #3》,除了同专辑的歌,它找出来的全是 Philip Glass——Etudes、Glassworks、Music in 12 Parts。冰岛后摇和美国极简主义接上了,两边没有任何标签关系。
它顺手查了一遍重复文件,164 首里找出 14 个。
为了看更大范围的效果,我又把「音频分析」这一层单独拿出来,跑了曲库里随机抽的 1160 首,65 分钟。
这里得解释一个数字:上一步每首差不多十九秒,这一步只有三秒半。差在单独跑跳过了几步:下载、声纹、还有另一套模型。
Chris Snelling 弹过一版《Nuvole bianche》,是 Einaudi 的曲子。机器在没有任何标签关联的情况下,把它匹配到了 Einaudi 自己的作品上,相似度 0.990。这条匹配跟标签无关,比的就是两首歌的音频特征。
JAM Project 的一首动画摇滚,它给出的头几条里,除了同门的 TOKYO DIVE,就是妖精帝國的《Patriot Anthem》,再往下是一整排动漫主题曲的翻唱。这几条跨了三个艺人、四五张专辑,共同点只有一个:听起来像。
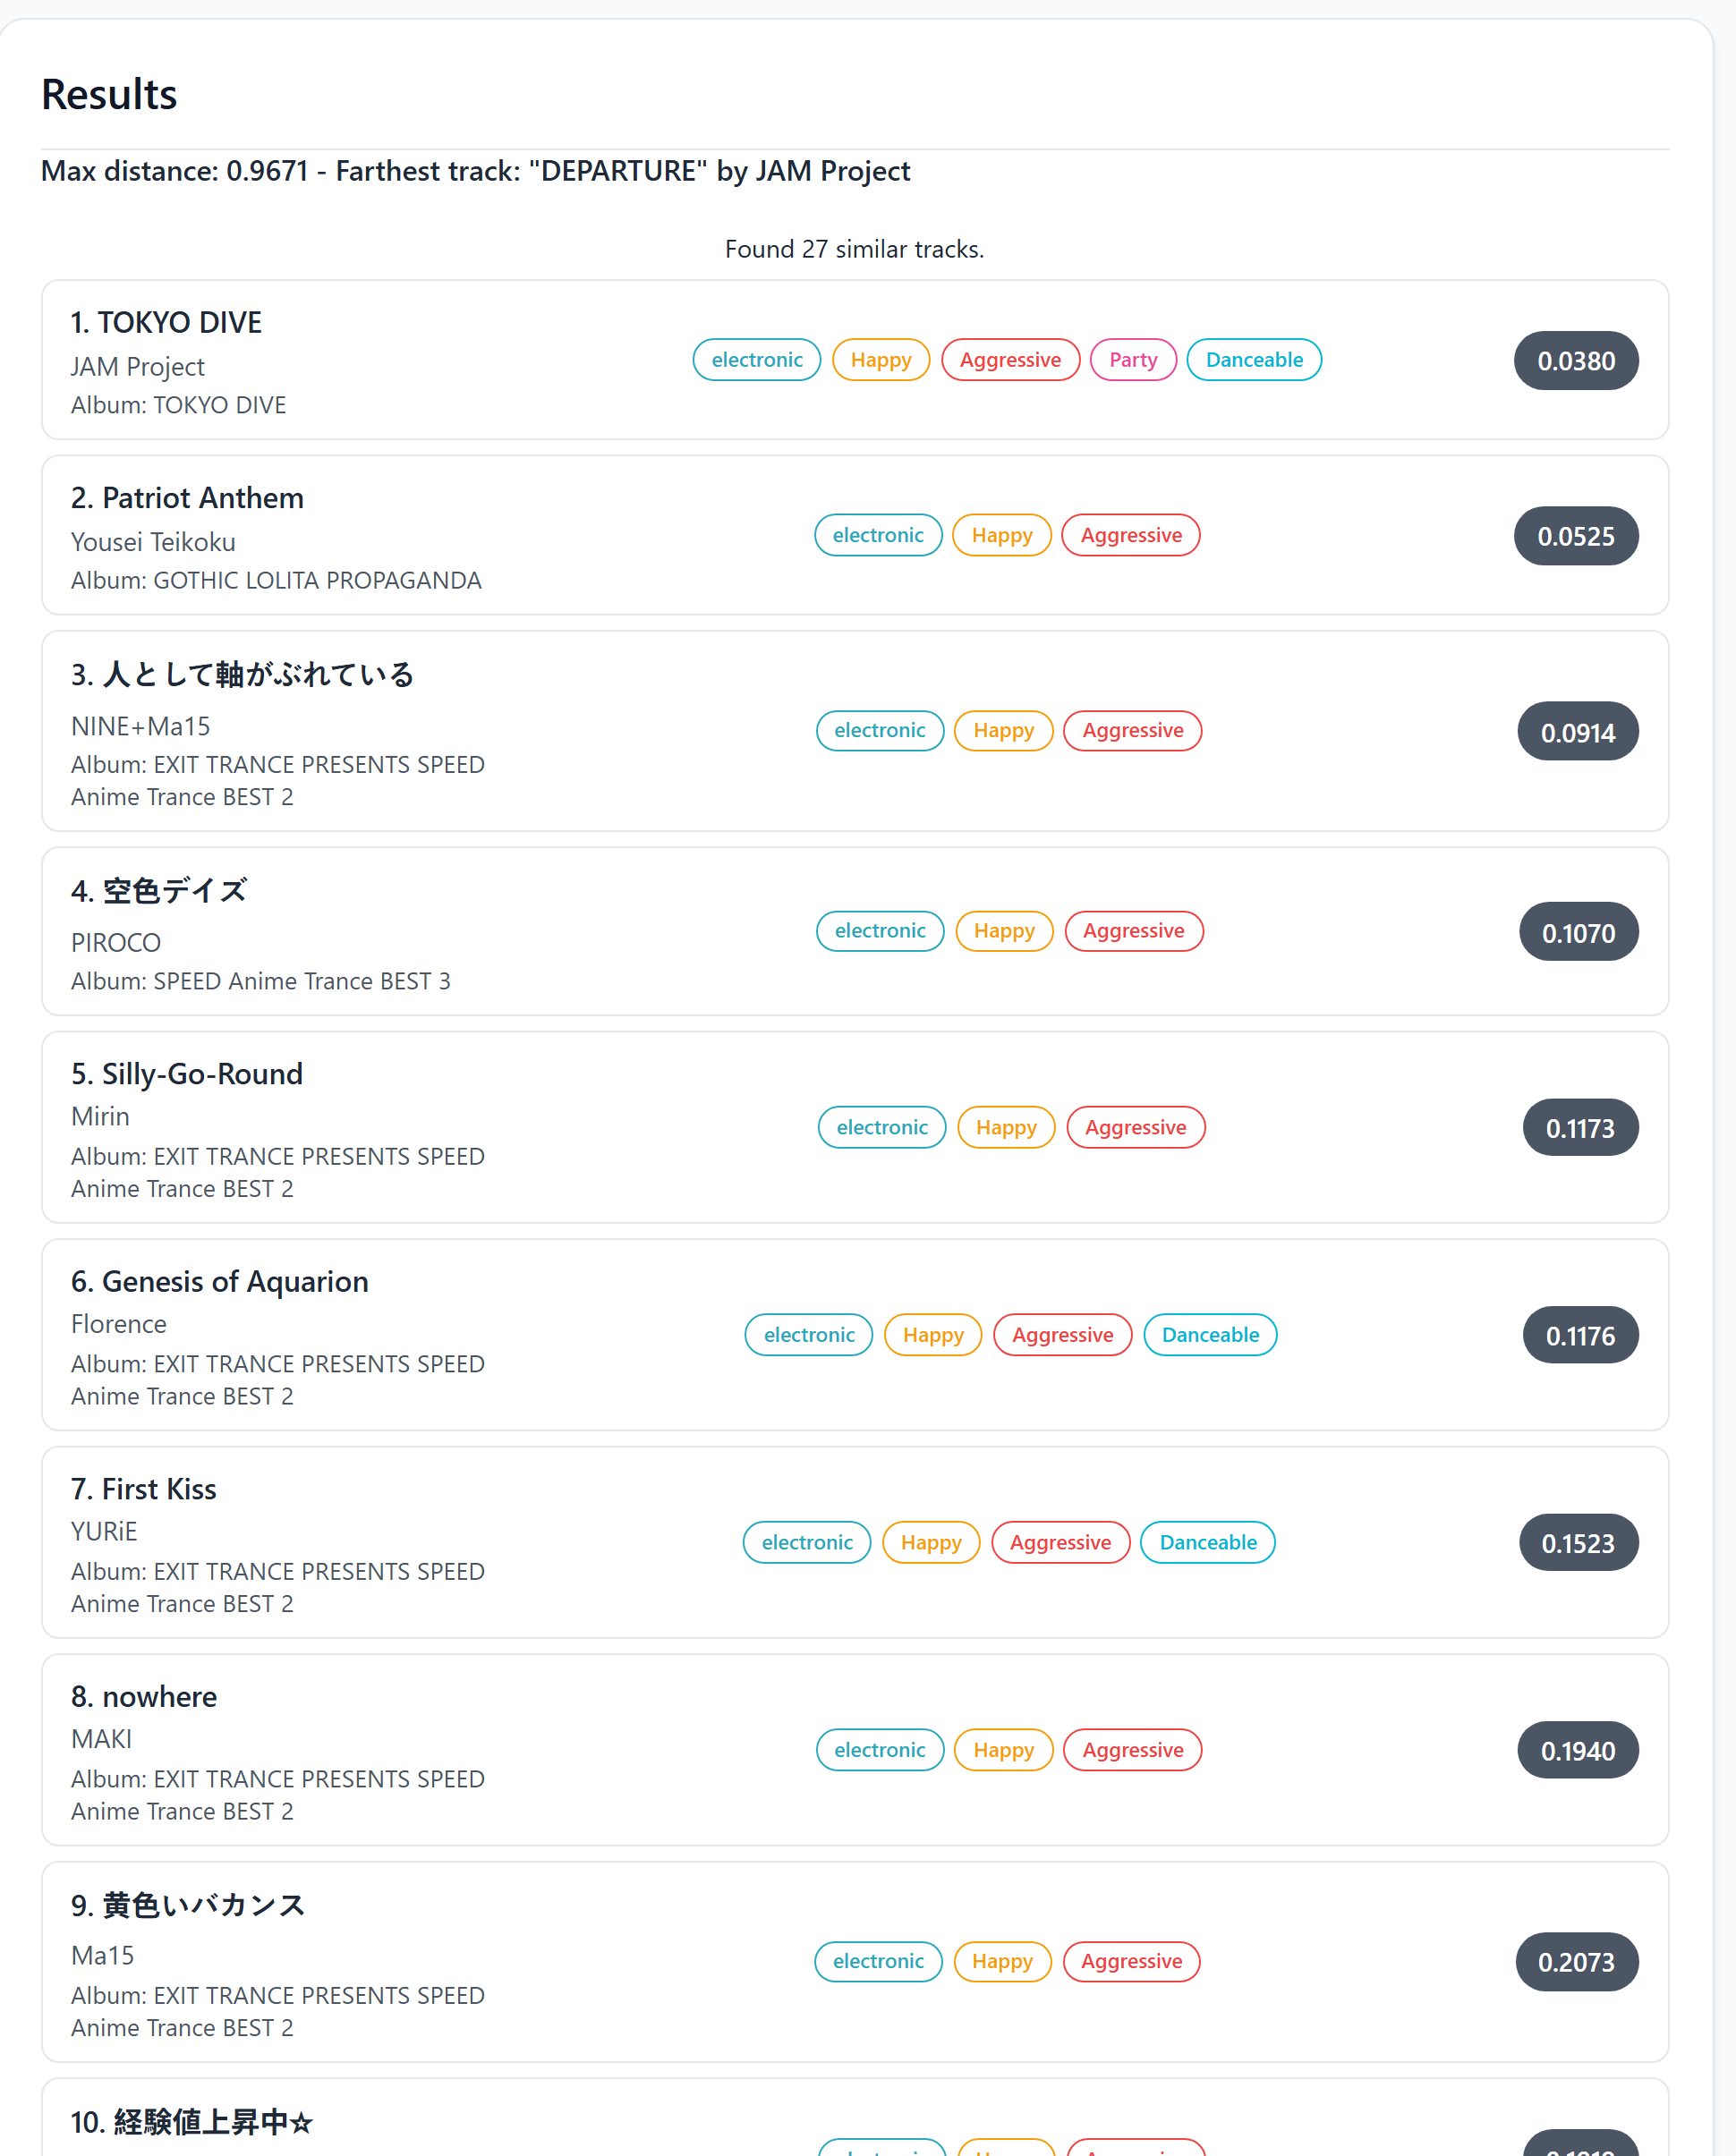
这 1160 首里,80% 的歌最像的那首来自别的艺人。只按艺人、专辑、流派翻,这些连接一辈子翻不出来。
功能
相似歌曲:任意一首歌,它给一串听起来像它的,按相似度排。
聚类歌单:它把整个库按声音自动分组,每组生成一个歌单,写回你的媒体服务器。我第一次跑出来两组,一组是 Glass 的钢琴,一组是 Glass 和 Sigur Rós 混着的氛围,直接出现在 Navidrome 里,手机上打开就能听。歌单名是它按情绪标签拼的,比如 Rock_Indie_Electronic_Medium_Sad_Relaxed,接上大模型可以让它起成人话。
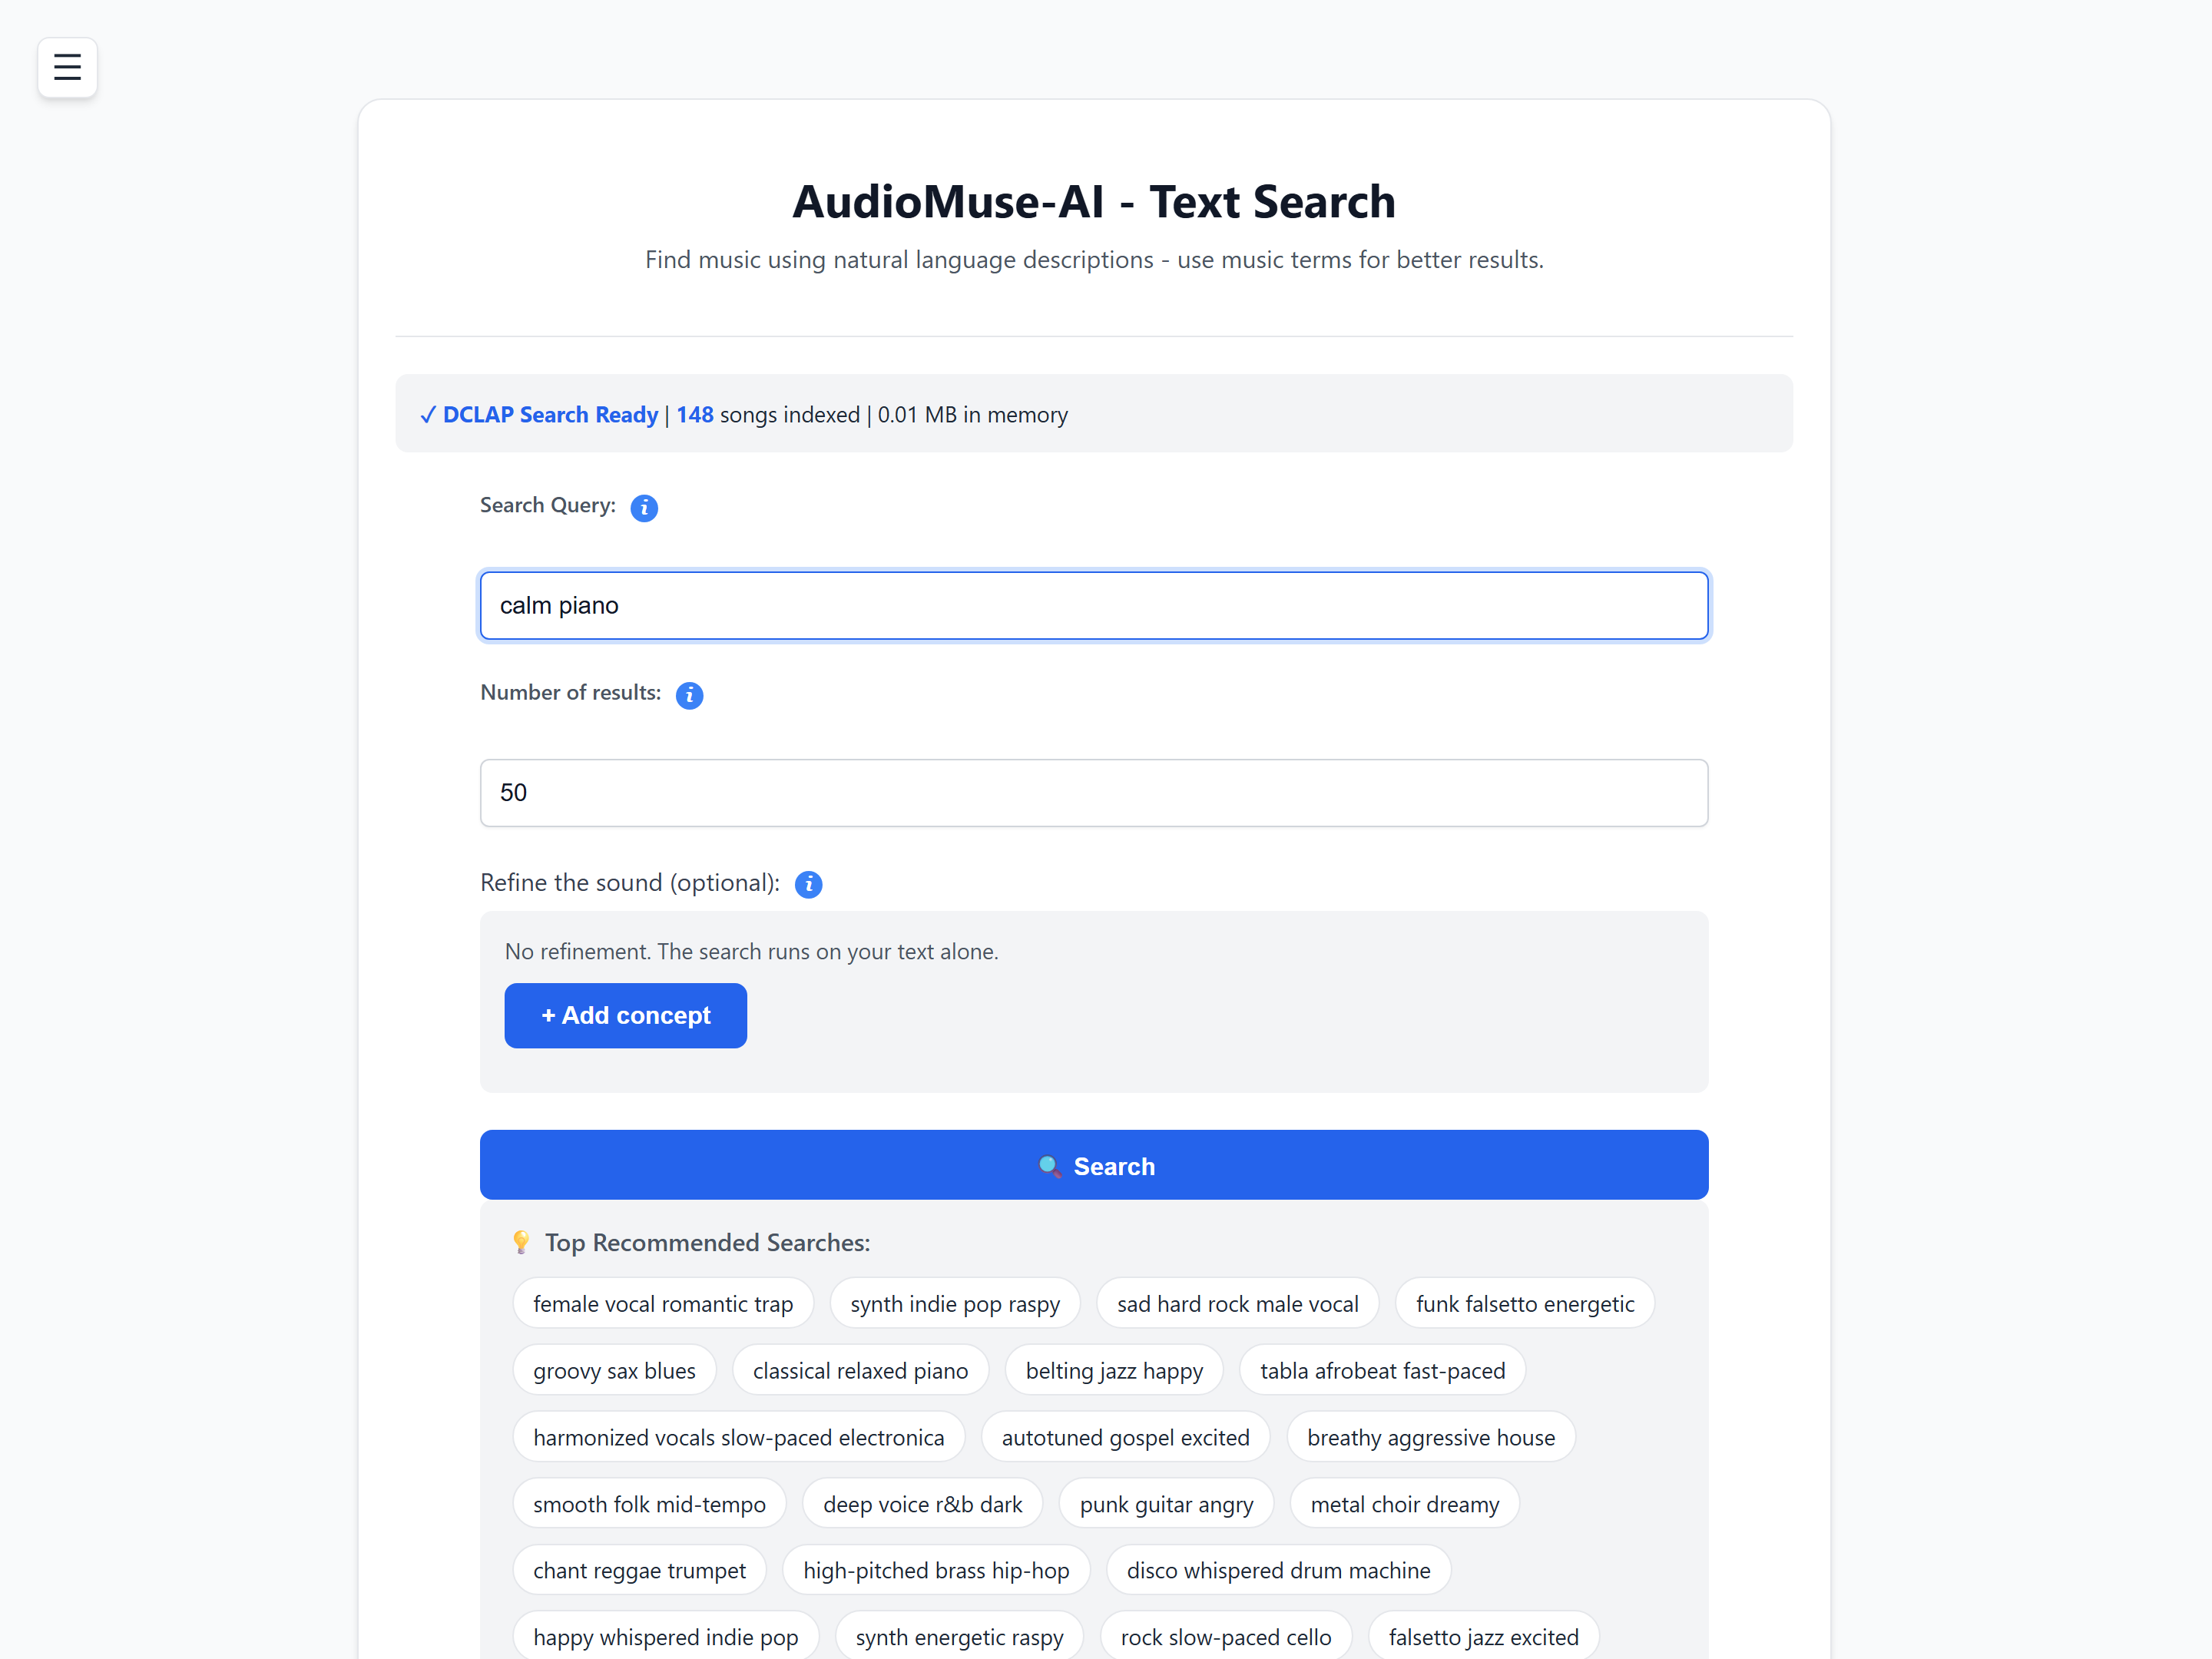
文字找歌:输入一句描述,它按语义去库里翻。输入 calm piano,出来的是 Closing、Etude No.5、Mad Rush,全是 Glass 的钢琴作品。音频和文字用的是同一套算法:一个模型把音频转成 200 个数字,另一个把文字转成同样长度的数字,两组数字差得越小就越匹配。官方建议两到四个词的组合最准,认乐器和流派最强,情绪弱一些。
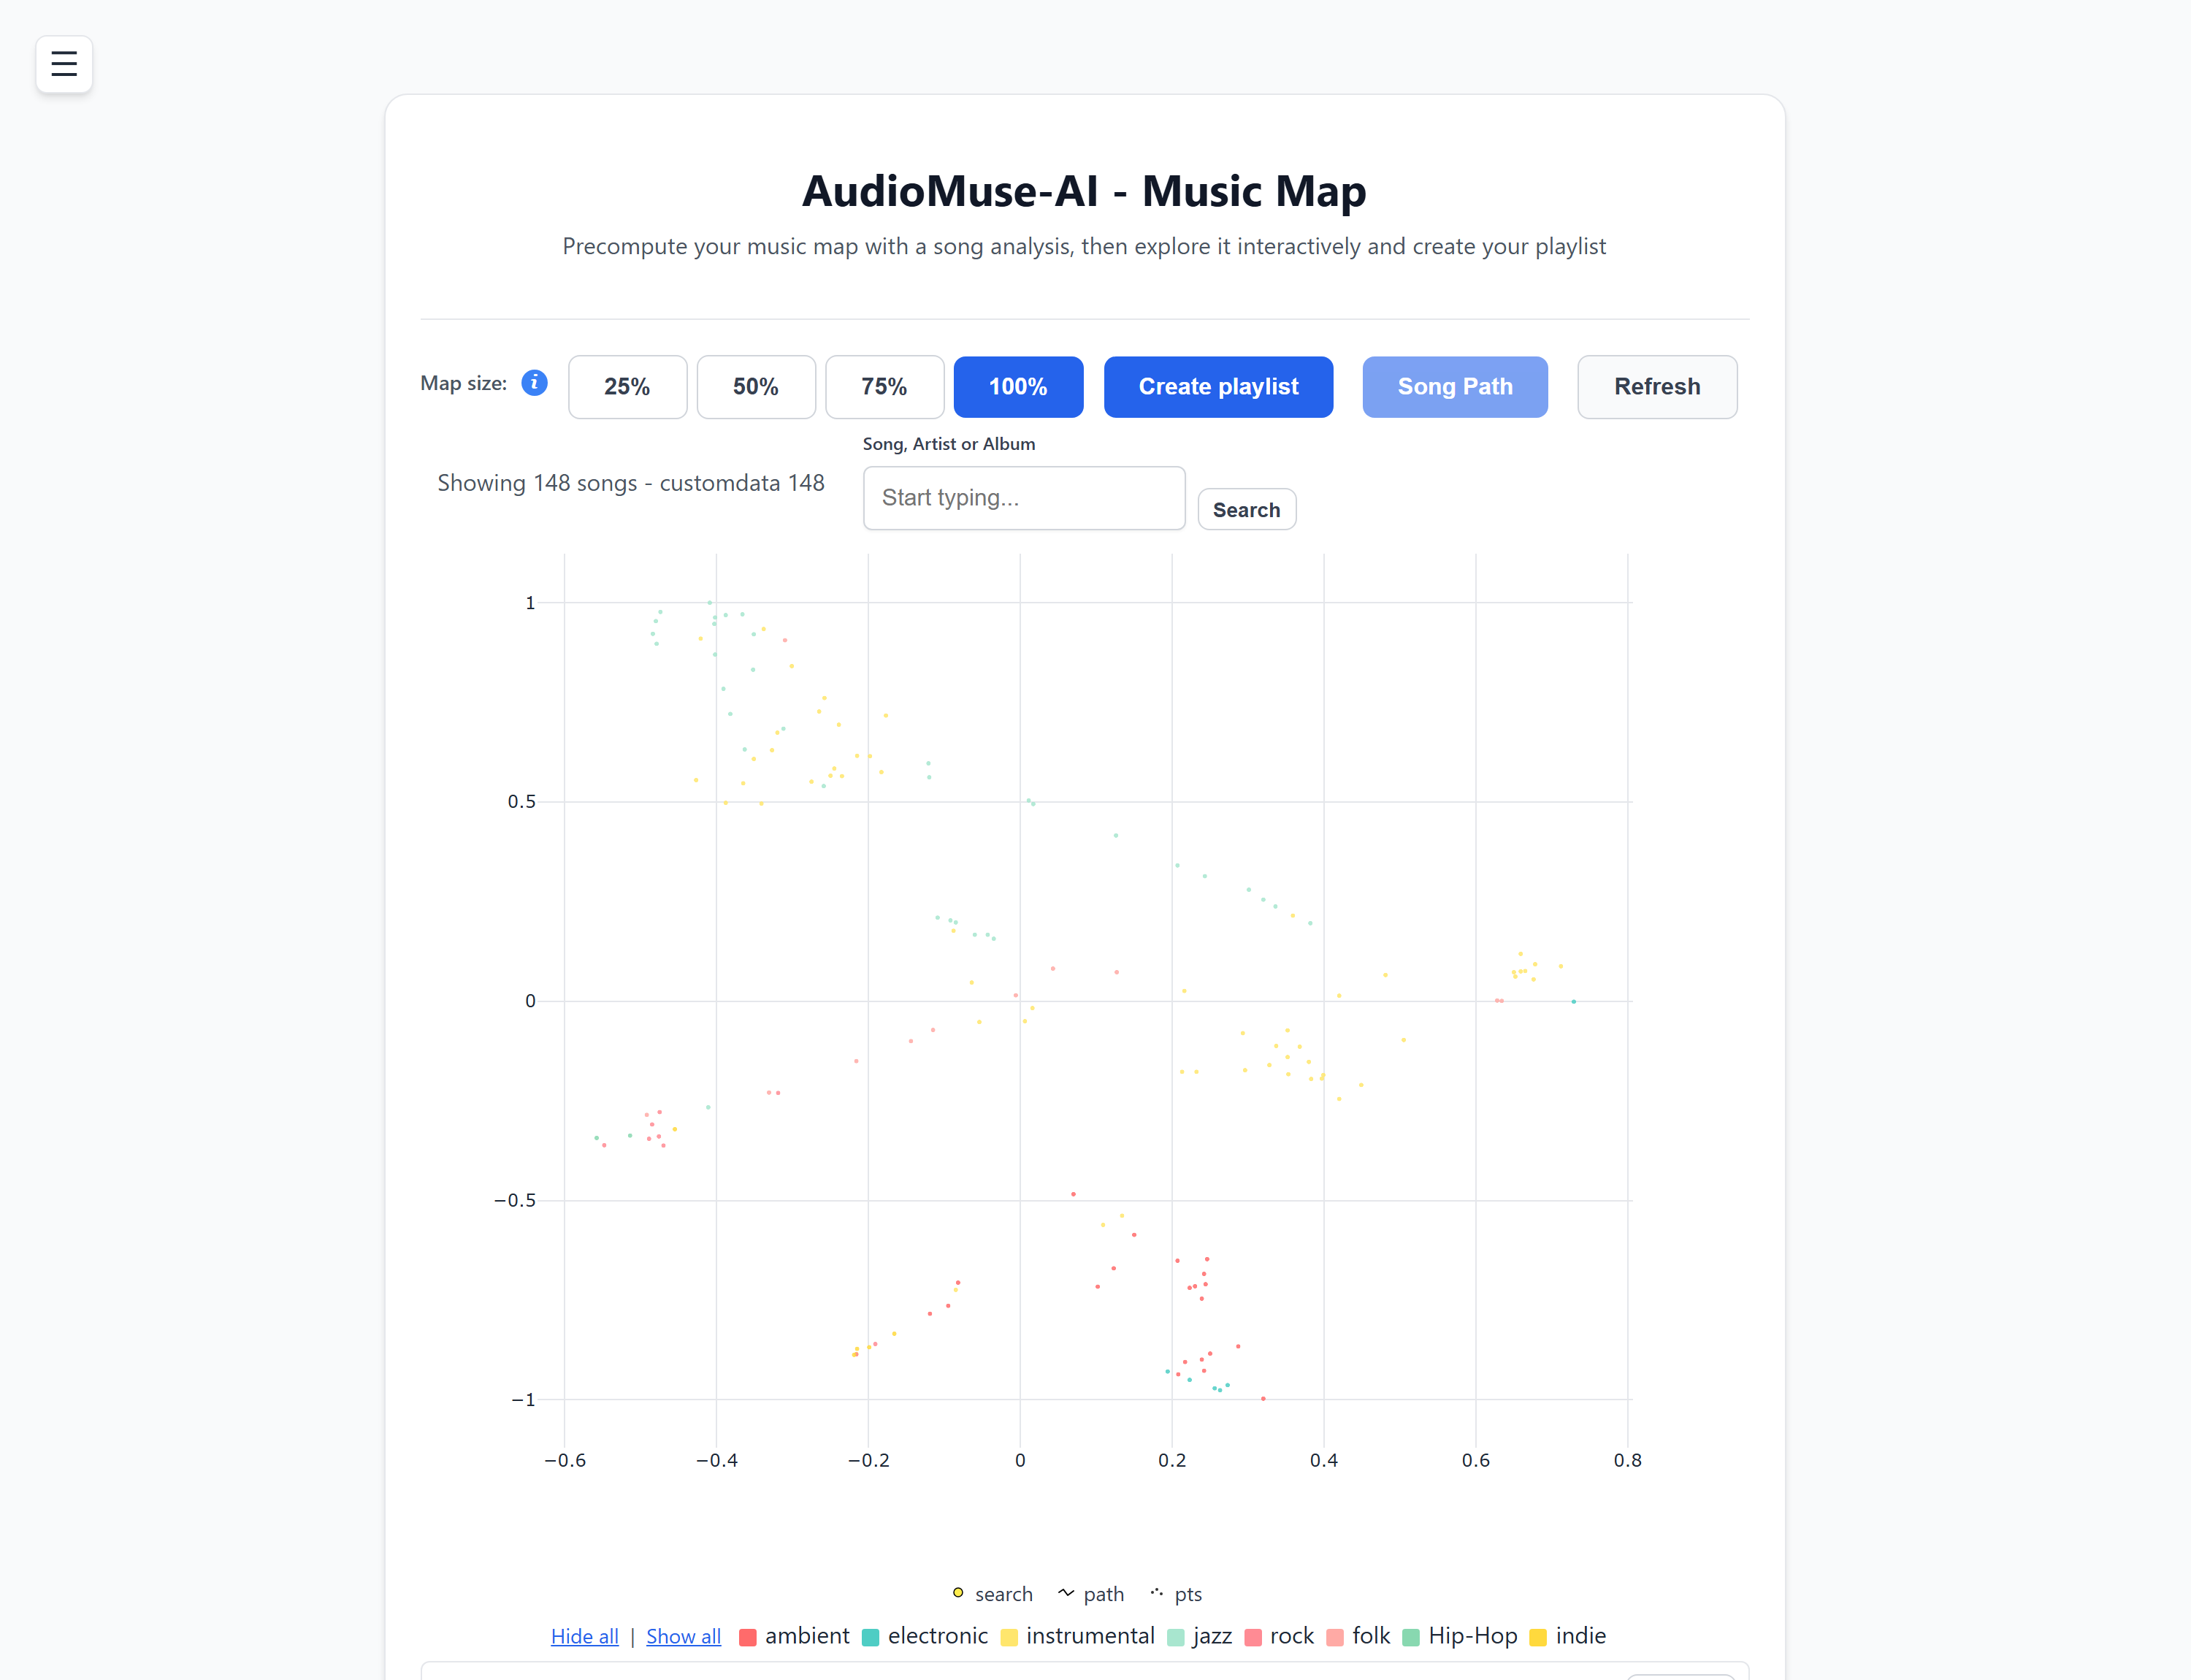
音乐地图:把库铺成一张二维图,挨得近的声音像。打开看到的是左上角一坨电子和氛围,中间散着钢琴,右下角一坨摇滚。这才 148 首,全库跑完应该很壮观。
还有几个没细试,比如按最近常听的找同类,在两首歌之间架一条路,或者录 20 秒声音让它猜歌。
代价
要一台常开的机器。服务器上用 Docker Compose,普通电脑用官方原生包,Windows、macOS、Linux 都有,自带数据库。官方建议 4 核 CPU、8G 内存、SSD,CPU 要支持 AVX2,2015 年后的 Intel 基本都有,虚拟机不透传 CPU 会直接起不来。
分析要花时间。官方说法是几小时到几天。这台机器 164 首用了 53 分钟,照这个速度,全库两万两千首得跑几天。中断能续,分析过的不会重算,适合扔在服务器上慢慢跑。
它要有一个媒体服务器。不能直接读文件夹,得连 Navidrome、Jellyfin、Emby、Plex、Lyrion 之一,从服务器拉音频。我本来就在跑 Navidrome,所以没什么影响。
歌词那一步最慢。库里没歌词的歌,它会跑语音识别去转录。我的库没有 lrc 文件,这次先把歌词关了,其他功能不受影响。
库越大越值得折腾,几十首的歌没必要。
尾声
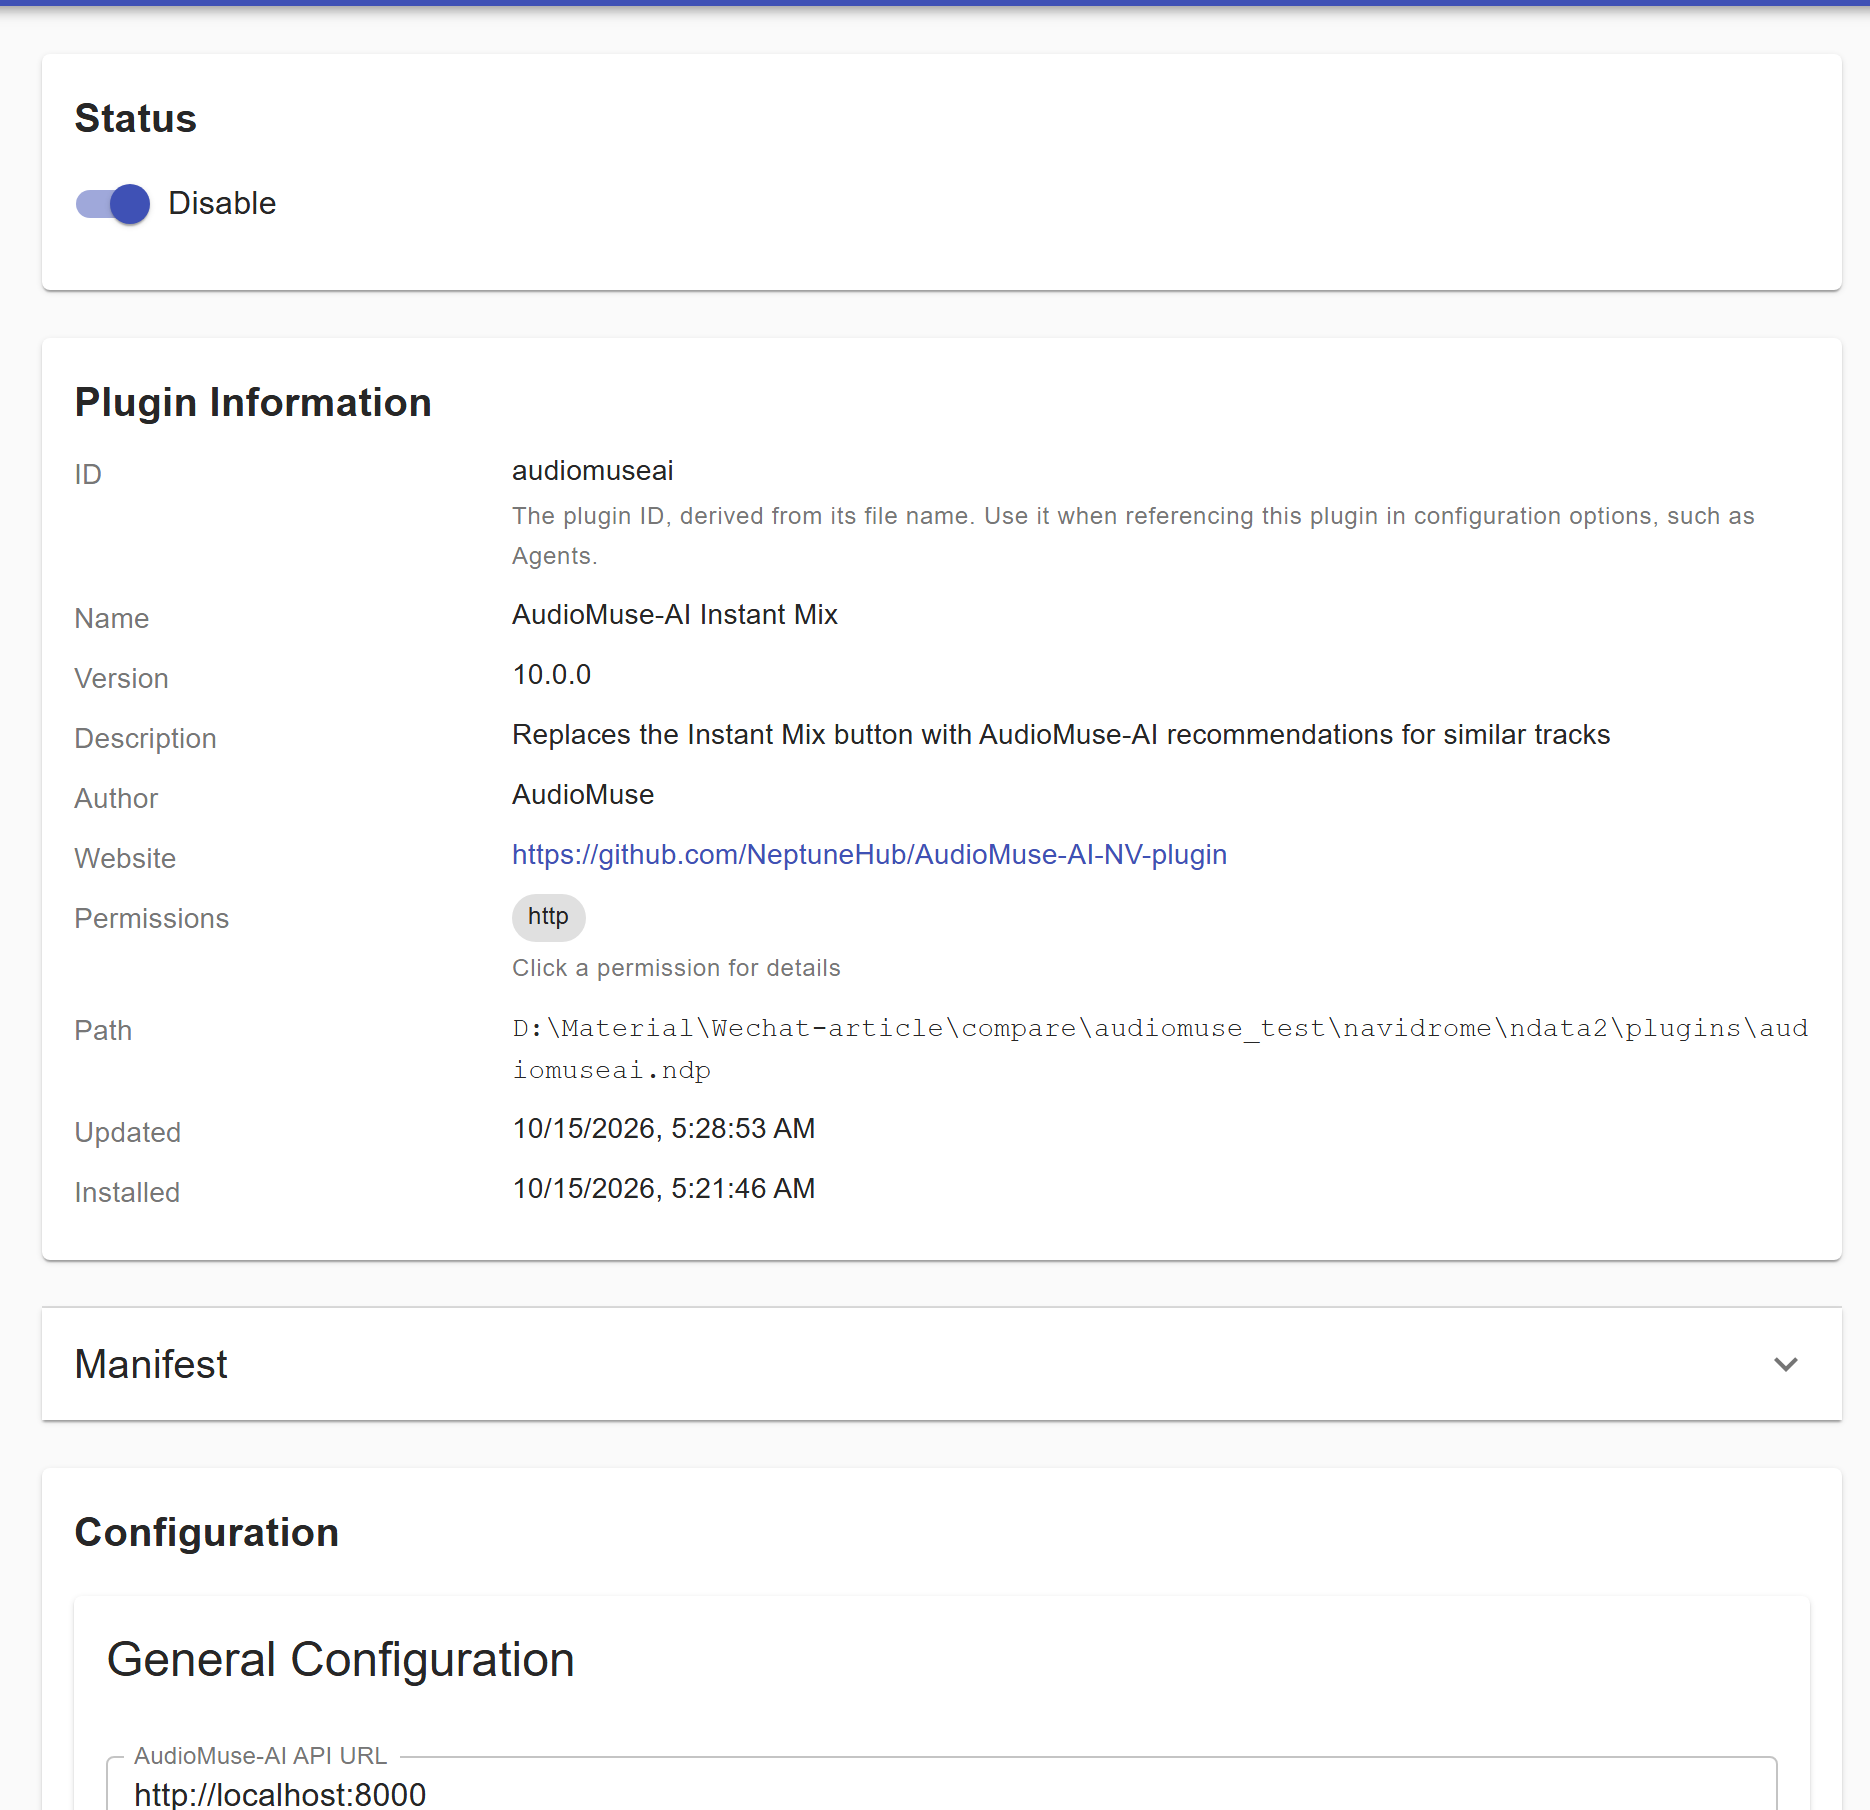
官方有个 Navidrome 插件。装完之后,Navidrome 里那两个入口换成了它算的:歌曲的 Instant Mix,和艺人页的相似艺人。不用切到别的网页。上面那两组聚类歌单也是直接写进 Navidrome 的。
上篇夸过 Navidrome 的客户端生态,Symfonium、Feishin、Sonixd 这一类,它们连上之后也能用上这套能力:在手机上点"相似歌曲",出来的结果就是 AudioMuse-AI 算的。播放器一个不用换。
要注意的是版本得对齐:Navidrome、AudioMuse-AI、插件三个一起更新。官方说版本不匹配是最常见的报错来源。
回到开头那个问题:两万多首歌,不知道听什么。这个工具确实帮上了忙——现在我点开的不再只有那几十首,那些被我忘掉的歌开始重新冒出来。
它要一台常开的机器,加几天分析时间。库里歌多到翻不动的话,这笔投入换来的就是这个。
项目地址
https://github.com/NeptuneHub/AudioMuse-AI
Jim Gadgets
Jim 发掘好用工具,探索有趣项目
这篇同期刊在我的公众号 Jim Gadget。回「我认可的」