AI 改简历别再闭眼用了:这个开源项目,改一句、代码验一句
2026-10-26 · 关于 Resume-Matcher
面试官顺着简历问下去,你答不上来的那一行,很可能是 AI 帮你改的。
让模型按岗位描述改简历,它很容易把 JD 里的词往你的经历上贴。JD 里写 Kubernetes,你只是用过 Docker,改完那一行就可能变成「熟悉容器编排」。贴得准,叫匹配;贴过头,就是面试里那个答不上来的问题。
Resume Matcher 这个开源项目,管的是后面这半截。目前 2.8 万 Star,Apache 2.0,装在自己的机器上,简历默认存在一个 SQLite 文件里。星是仓库从 2020 年攒到现在的;最早做的是简历和 JD 的相似度匹配,2025 年旧版存档,新代码另起一条线。名字还叫 Matcher,现在主要做的是定制和导出。
它的做法是把写作和核对分开。模型负责改,代码负责验。
立一份主简历
整个流程从一份主简历开始。
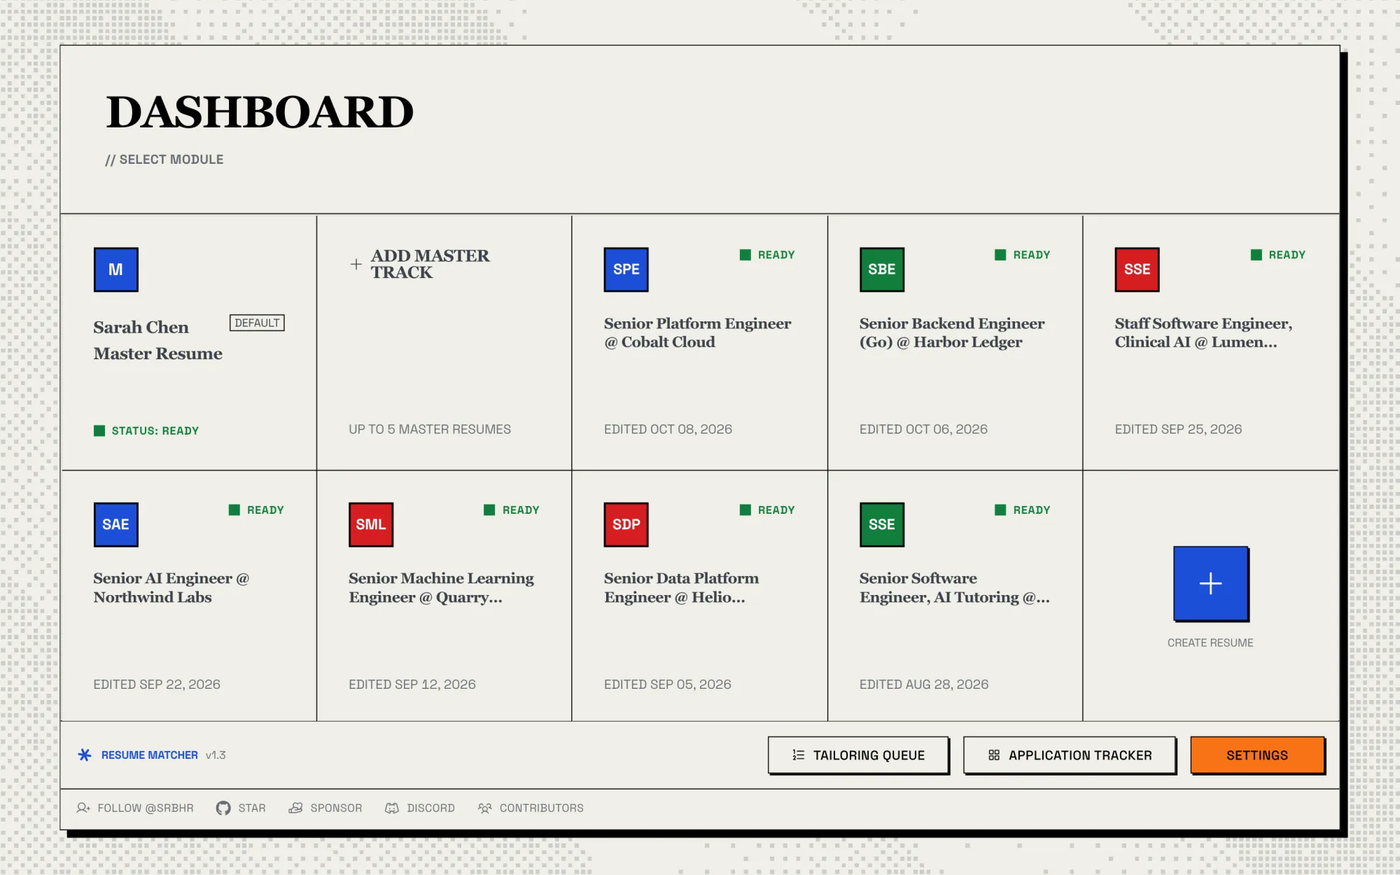
你把现有的简历(PDF 或 DOCX)传进去,它解析成结构化字段,联系方式、摘要、工作经历、项目、教育、技能。之后每投一个岗位,都从这份主简历里取内容,生成一份定制版。目前最多五份主简历,够你把不同方向分开投;其中一份设为默认,定制版可以有很多份。
每投一个岗位就改一版,改到第十版,你已经分不清哪句是最初写过的。主简历的作用就在这儿。不管改多少版,内容都从同一份底稿里取。
后面的核对有没有参照物,取决于主简历。有了它,新增的数字、工具名、技能,都能拿回去查,看原来那版里到底有没有这个词。
简历也能从零开始建。它有一个对话式向导,一段段问你的经历,边问边成稿。
改一句,验一句
定制时的提示词写得很硬。不许加主简历里没有的技能、工具、证书;不许编数字;不许加主简历里没有的公司名、产品名、技术名词。
提示词降低概率,降不到零。同一个模型,同样的提示词,今天不编,明天可能编。
目前的 1.4 版本加了一道自查流程。代码规则先扫一遍摘要和每条经历,标出三类句子——有破折号的,开头是 Responsible for 和 Helped with 这类说法的,只写动作没写结果的。被标出的句子交给模型改一次,改完先跟原句对,数字不能多也不能少,名字、工具、技能不能增删。对不上,这次改动直接丢掉。
原句是「把结算服务的响应时间从 800ms 降到 300ms」,改写版多出一个「40%」,这一版就进不了简历。改动不会直接落到简历里,而是以 diff 的形式列出来,你逐条过。
补关键词走另一条路。主简历里出现过的词,它直接补进去;主简历里没有的,界面会让你亲手确认一句「我有这个」。确认之后,这个词只进技能栏和最多两行经历。缺的词列在一边,主简历里已经有的列在另一边。
这个设计里,两件事分得很清楚。你有没有这个技能,由你确认;你有没有把它写进去,由代码检查。
我最看重的是这道核对。模型越强,越需要一道不依赖模型的检查。
把打分交给代码
ATS 是招聘方筛简历的那套系统。Resume Matcher 的 ATS 分数不调用模型。解析不出来的简历,招聘的人可能看不到。
五项加权,权重写在代码里。
| 评分项 | 权重 |
|---|---|
| 关键词匹配 | 40% |
| 技能覆盖 | 20% |
| 岗位标题匹配 | 15% |
| 章节完整 | 15% |
| 日期格式一致 | 10% |
如果分数由模型给,同一个岗位、同一份简历,今天 79,明天 83,这种分数没法用来判断改得对不对。
关键词和标题占得多,因为很多招聘方筛简历时,最先看的就是这两样;日期格式单独占 10%,因为格式混着写,解析器会把工作年限算错。
关键词匹配认中文,中文词按子串算,英文词按词边界算,java 不会命中 javascript。
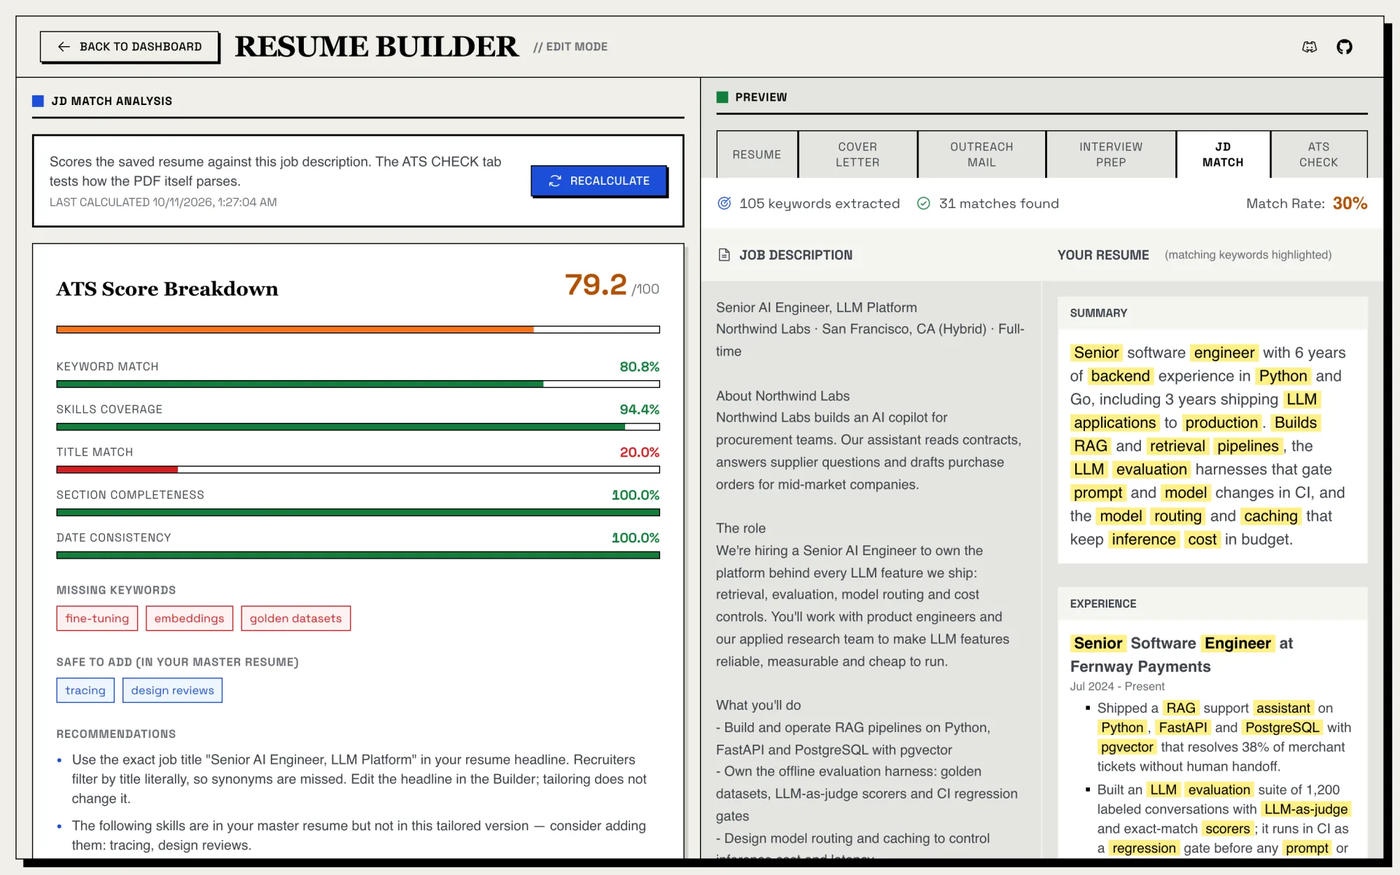
那张 JD Match 的截图里,项目示例简历的总分 79.2,岗位标题匹配只有 20 分,是五项里最低的。它没有替你把标题改成 JD 上的写法,只在建议里写了一句:按标题字面筛人的招聘方不少,同义词会被漏掉;要改,去 Builder 里自己改。
分数因此低了一截,但头衔不会在你不知情的时候被换掉。
ATS Check 做的是另一件事。它把你导出的 PDF 重新解析一遍,用的是 pdfminer,跟招聘系统里的文本提取器一个路子。文字层够不够,有没有乱码,多栏、表格、文本框、页眉页脚、联系方式、章节标题,一项项列出来。
很多简历栽在 PDF 上,字却没被提取出来。
两栏模板最容易串行,解析出来的顺序可能是一行左、一行右。
写作质量另有一个 0 到 100 的分,在 Builder 的 Writing 标签里,按固定规则打分,改完看前后对比。
从主简历到 PDF
主简历、按岗位定制、封面信、面试准备、导出 PDF,是一条完整的线。队列页可以一次贴进多个 JD,后台一个一个跑,中间可以设冷却,避开服务商的限流;队列存在数据库里,重启不丢。
封面信走同一套,默认 200 到 300 词,名字、数字、公司信息都要有出处;面试准备也从简历里的经历出发。
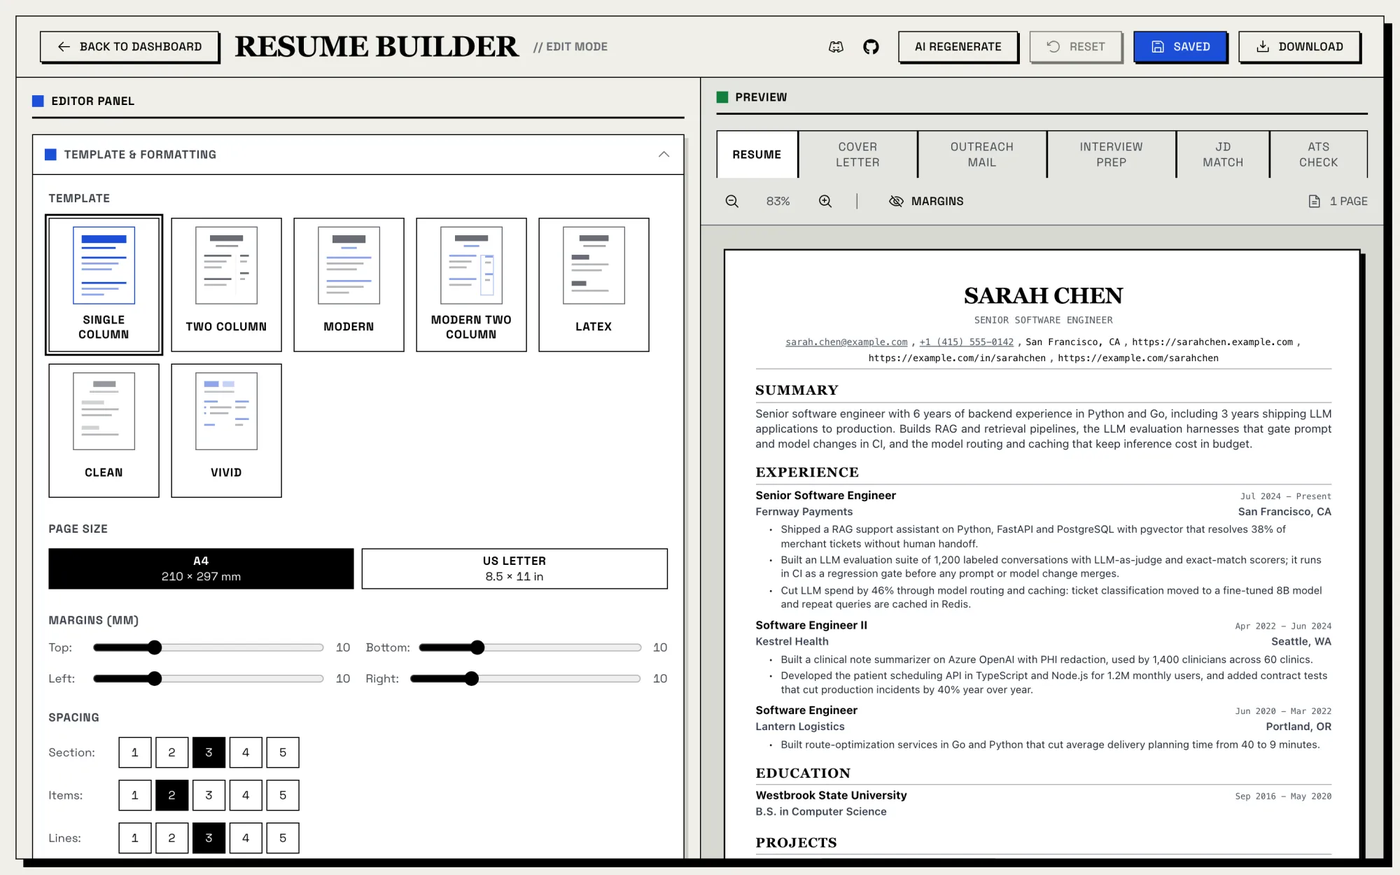
模板 10 套,A4 和 Letter 两种纸张,导出的 PDF 带文字层;其中 7 套有可编辑的 LaTeX 工程——能直接放进 Overleaf。
界面 7 种语言。中文要留意字体,Docker 镜像里带了 Noto CJK,不用 Docker 的 Linux 机器要自己装一套,否则 PDF 里的中文会变成方框。
1.4 还加了一条路:MCP。MCP 是让 agent 调用外部工具的协议,Claude Code、Cursor、Codex 可以直接驱动它。agent 负责写,Resume Matcher 负责存、验、打分、渲染,不用另配 API key。改完可以直接要一份校验结果,不合格就再来一遍。
agent 不保存你的简历库,也不跑解析检查。这两件事留在 app 里。
装起来要两个终端,后端用 uv,前端用 npm;Windows 的步骤在 SETUP.md 里单列了一节。
Resume Matcher 不适合谁
安装要终端。Python 3.13、Node 24(.nvmrc 里卡到 24.22.1)、uv。README 里写着,它是给写软件的人做的;不熟终端、版本不对,第一步就得先折腾环境。
云端模型会把简历文本发出去。数据默认存在你自己的 SQLite 文件里;推理走不走外网,取决于你选哪家。只有 Ollama 这种本地模型,简历才真的不出机器。
ATS 分数跟招聘系统里的真实评分不是一回事。HR 怎么想,它测不了。
事实核对是词法级的。新数字、新工具名、新技能会被拦下,把同一件事换个说法写得更漂亮,它拦不住。最激进的那档改写——项目自己标了幻觉警告。
模板和写法是给英文技术简历准备的。Deedy、LaTeX 那几套,投外企和海外岗位合适;中文简历的排版习惯,不一定对得上。
如果你一年只改两三次简历,ChatGPT 够用,改完自己逐句核一遍就行。如果你在密集投递,或者简历里有不方便外传的东西,把它跑在自己的机器上,至少新增的数字和工具名,会先被代码拦一道。
换成我,会先跑 ATS Check,看它把你这份简历的 PDF 解析成什么样。
AI 可以替你写简历,但「这句是不是真的」,最好别由模型自己回答。
GitHub  https://github.com/srbhr/Resume-Matcher
官网 https://resumematcher.fyi这篇讲的项目在这:Resume-Matcher · 仓库
这篇同期刊在我的公众号 Jim Gadget。回「我认可的」