把长视频切成 30 秒一段,VideoRAG 让你直接问它
2026-10-20 · 关于 VideoRAG
一段三小时的访谈,你记得里面有一句话,只记得大概在中间偏后。于是你拖进度条,停下,听十秒,再拖。十分钟后,你放弃了。
视频里的内容分两半:说出来的话,和画面上发生的事。前一半还能靠转写抢救,后一半只能靠人盯着看。网页能全文搜,PDF 能全文搜,手机相册能按内容搜,视频这两半都还没有搜索框。
VideoRAG 就是冲着这件事来的。港大 HKUDS 实验室的作品,三千四百多颗星,论文收录在 KDD 2026,配套的桌面应用叫 Vimo,官方给它的说法是「跟你的视频聊天」。
它做的事,是给视频建一份能查的索引。
GitHub 自动生成的仓库卡片:6 位贡献者、20 条未关闭的 issue、477 个 fork。
建索引
它的第一步是把视频切开。
代码里这个默认值写得很直接:video_segment_length = 30,每 30 秒一段。
每一段抽 5 帧画面,交给视觉模型生成一段英文描述。同一段的声音送去做语音识别,支持中文、英文、日语。半分钟的片段,变成了一小段文字:画面描述加声音转写。
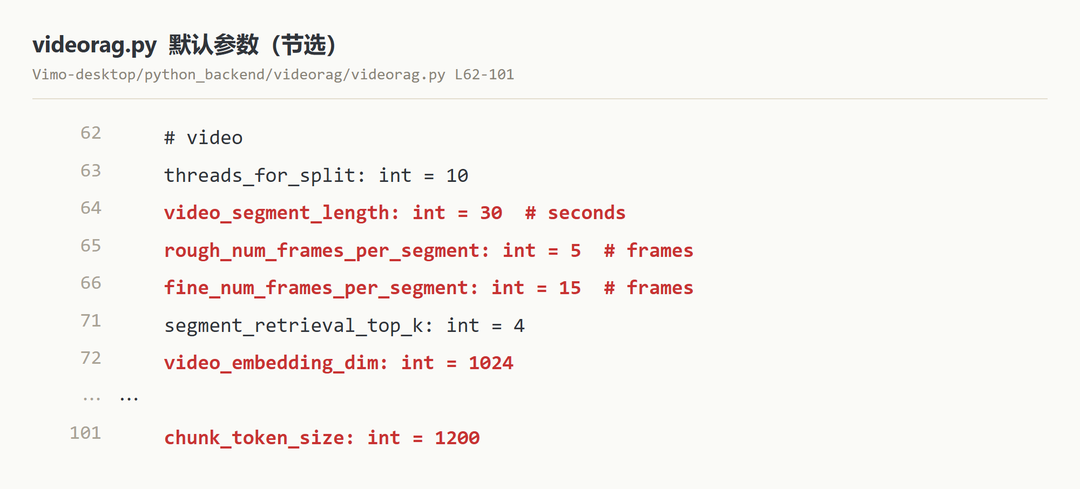
这段参数来自桌面版后端,图里带着文件路径和行号。
这些文字再拼成一块块 1200 个 token 的文本,token 是模型处理文字的计量单位。模型从里面抽人物、地点、事件,还有它们之间的关系,连成一张图。这张图建在所有视频之上,不按单个视频隔开。图谱检索的来路,官方写在致谢里:LightRAG 和 nano-graphrag。
画面还有另一条线。每一段视频由 ImageBind 编码成 1024 个数字的向量,存进向量库。
两条检索路径分工不同。你问「他为什么离开那家公司」,答案多半在转写里,文字索引就够用。你问「他在黑板上写了什么」,得让程序拿你的问题去比画面向量。
30 秒这个长度,是精度和调用次数之间的折中。段切得越短,指得越准,模型要跑的次数也越多。每一段都要调用一次视觉模型。
为什么不把视频直接丢给模型?几百小时的内容,上下文装不下。先翻成能检索的东西,后面的提问才跑得起来。
视频难搜,难在信息分散在画面和声音里。这套流程把它翻成可检索的文字和向量。
提问
桌面版的操作不复杂:选好视频文件,点开始。等索引建完,就能提问了。索引只用建一次,之后每次提问,程序都查这份索引。
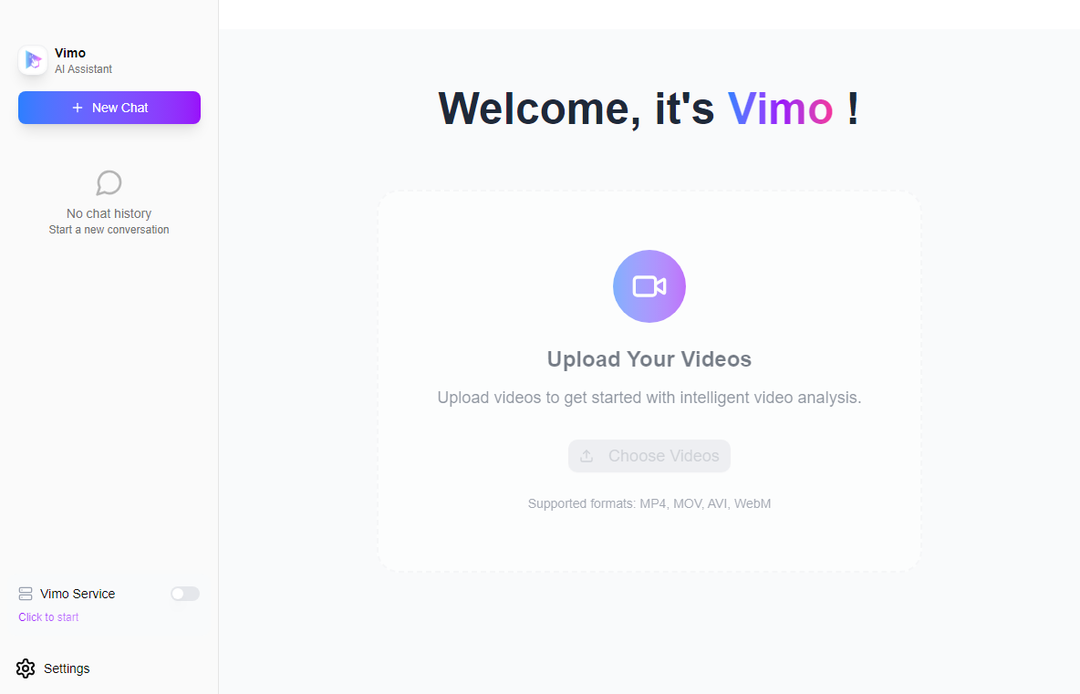
主界面只有一个上传入口和一个对话框;左栏那个开关用来手动启停后台服务。
你问一句话,它先把问句改写成一句陈述,再拿这句陈述去检索。程序分三路去找:在文字索引里检索相关段落,在知识图谱里检索相关的人和事,把问题编码成向量后和画面向量比相似度。
检索返回的候选片段不会直接用。程序先让模型按相关性筛一遍,判断这段粗描述里是否可能包含答案。被选中的片段,重新抽 15 帧,比建索引时更密,交给模型生成一遍更细的描述,再连同相关文字一起生成答案。
代码里的提示词连答案格式都规定了。句子后面标序号,末尾列出出处,格式是「视频名, 05:30, 08:00」。桌面版现在把出处关了(param.wo_reference = True)——答案里没有视频名,也没有时间点,设置界面里找不到对应的开关。
一个会话里放多个视频,检索范围覆盖这些已索引的视频。
成绩单
官方给了三组数字。
一组在自建的 LongerVideos 上,问的是「两个答案哪个更好」,由模型两两投票。VideoRAG 对普通的文字检索胜率 53.3%,对带知识图谱的几个方案在 53.9% 到 57.1% 之间。赢是赢了,离五五开不远。
另一组在公开的 Video-MME 长视频赛道:答对 60.2%,带字幕的基础模型是 56.3%。
还有一张 1 到 5 分的对比表,Vimo 4.45,NotebookLM 3.37,评分由另一个大模型给出,评的是观感。
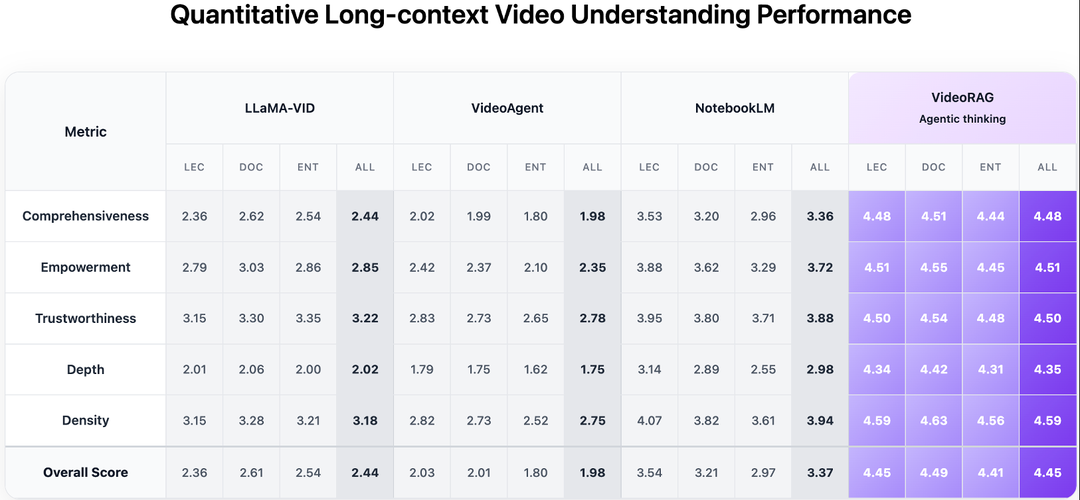
表里 LEC / DOC / ENT 是讲座、纪录片、娱乐三类,最右一列是总评。
VideoRAG 的成绩比同代方法好,但没到代差。
门槛
现在没有能直接安装的版本。
眼下两条路,都得自己动手。
一条是桌面版,源码跑两个进程,一个 Python 后端,一个 Electron 前端。描述生成用阿里云的 qwen-vl-plus-latest,语音转写用 paraformer-realtime-v2,问答请求走 OpenAI 兼容接口,默认 gpt-4o-mini。两个 key 都是必填。本地要跑的只有 ImageBind,权重 4.8 个 G,第一次打开就要下。ImageBind 在 Mac 上只能走 CPU,因为三维卷积不被 MPS(Mac 的图形加速接口)支持,有 N 卡的机器才用得上显卡。
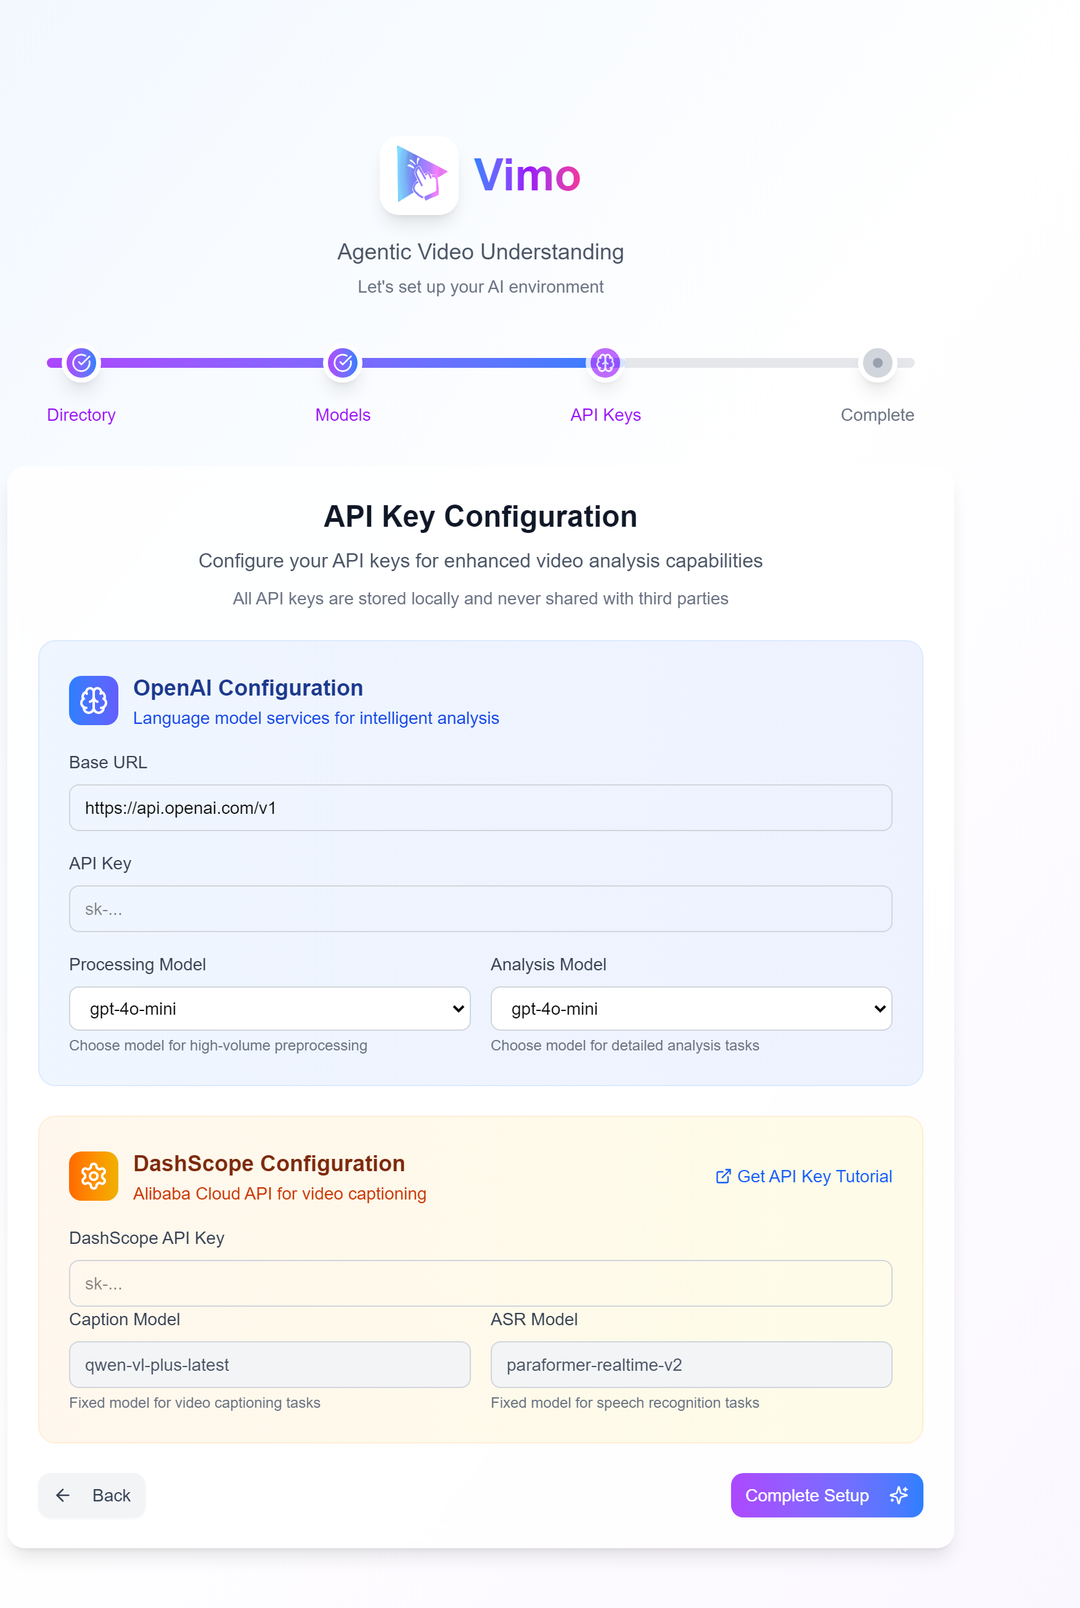
两个 key 在同一个页面里填;描述和转写那两栏的模型名是固定的。
离开本机的不是整个视频,是抽出来的帧、切出来的音轨和转写文本。访谈、未公开的课程这类素材,算清楚再上传。
另一条是算法版,描述用 MiniCPM-V,转写用 Whisper,检索用 ImageBind,三步都在本地,官方说单张 24G 显卡就能处理几百小时。代价是权重自己下、环境自己配,而且注明测试覆盖的是英文环境。中文视频能转写,效果没有公开数据。
桌面版支持 mp4、mkv、avi、mov、webm 这些常见格式。
仓库的 issue 列表里,有人卡在「实体抽取」几个小时不动,有人 GPU 进程直接崩掉,有人遇到模型二进制不兼容。官方还留了一条注意事项:导入过的视频不能移动、不能改名,路径一变,索引就找不到原片。
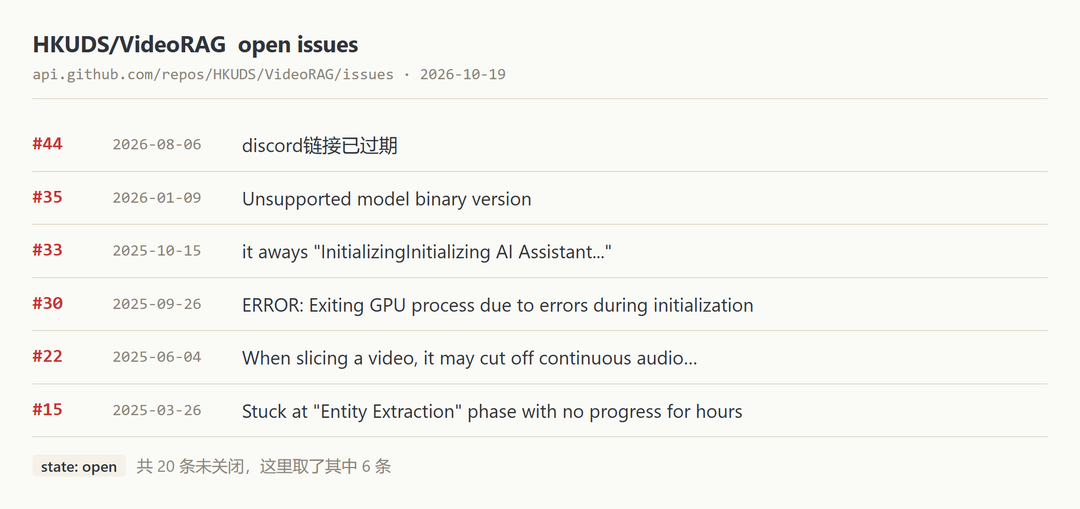
图里这 6 条都还开着。
尾声
只想找一句话,不必等它:先把视频转成文稿再搜,这条路今天就能走通。YouTube 和 B 站自带字幕,本地用 Whisper 也能把录音转成文字。课和讲座以口述为主,这一招够用。
演示、手工、体育这类视频,答案往往只在画面上。VideoRAG 多出来的就是这一块:点了哪个按钮,两个人谁先伸的手,白板上的数字谁抄错了——这些大多只能回到画面里确认,文稿里未必有。
手上真攒着几十上百小时,又愿意自己配环境的,可以盯着这个仓库。
回到开头那段三小时的访谈:你记得的那句话,现在仍然只能靠拖进度条找到——除非有人先替它把索引建好。
项目地址
https://github.com/HKUDS/VideoRAG
论文
https://arxiv.org/abs/2502.01549