WeClone:用聊天记录,训一个说话像你的人
2026-10-27 · 关于 WeClone
想用微信聊天记录训一个说话像你的模型,WeClone 曾经是最直接的一条路。现在它的数据源表格里没有微信。
WeClone 做的是用聊天记录微调一个模型,让它回话像你。仓库现在 18,332 颗星(截至 10 月 27 日),AGPL-3.0,Python,2024 年 1 月建仓。
换数据源
它最早是微信项目。2025 年 4 月的 v0.1.2 README 里,数据准备写的是用 PyWxDump 提取微信聊天记录,导成 CSV,放进 ./data/csv;部署那节还留着 itchat 方案,标着已弃用。
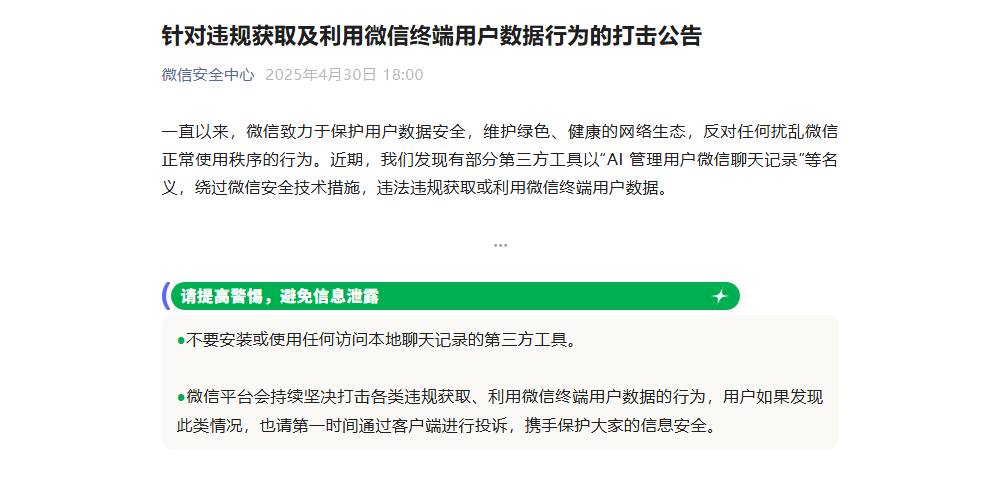
2025 年 4 月 30 日,微信安全中心发了一篇打击违规获取微信数据的公告。公告点名了一类第三方工具。它们以「AI 管理用户微信聊天记录」等名义,绕过微信的安全措施。公告里还有一句提醒,不要安装或使用任何访问本地聊天记录的第三方工具。
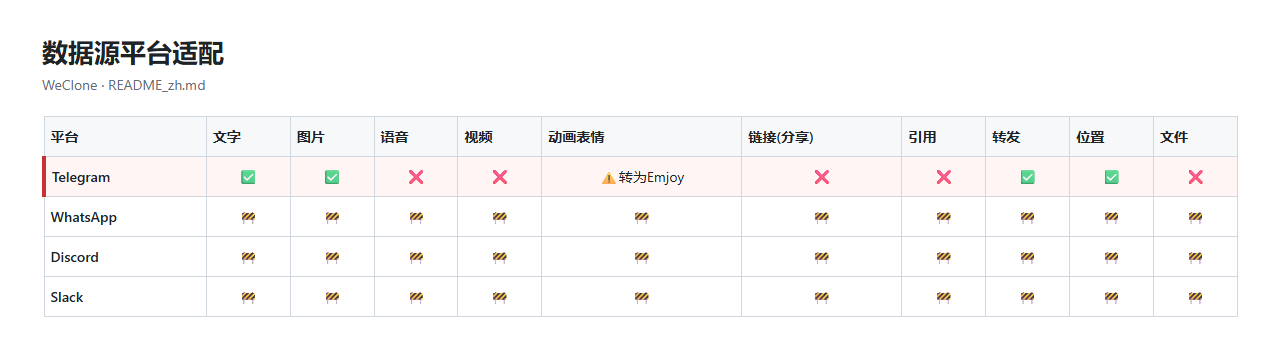
2025 年 7 月 16 日,WeClone 的提交记录里多了一条 remove wechat,提交号 785ad1472a。现在的数据源表格里,Telegram 那一行全是勾,微信不在表里。名字还叫 WeClone,免责声明里也还挂着那篇公告的链接。
部署表里,个人微信那一格还是勾,括号里写着 openclaw-weixin——腾讯自己维护的 OpenClaw 微信通道插件,扫码登录,收发消息。数据源是拿什么训练,部署是把模型接到哪个聊天入口。个人微信能接,但微信聊天记录导不进来。
微信打击的是读本地聊天记录这条路,发消息的机器人通道还开着。
官方支持的数据源里,只有 Telegram 是通的。用 Telegram Desktop 导出 JSON,把 ChatExport_* 文件夹放进 ./dataset/telegram,在配置里填自己的 user id,然后跑 weclone-cli make-dataset。
图片走 media_dir,训练多模态模型时换另一份配置模板。
预处理先过 Presidio,过滤电话号码、邮箱、信用卡和 IP;地理位置、身份证号也在范围里。配置里还有 blocked_words,命中整句删掉。README 自己写着,过滤不能保证 100%。
默认存储模式是加密的,密钥在 .weclone/ 目录里。忘了密码,旧密文解不开;加密模式也不支持分布式训练。
训模型
数据会被切成问答对。同一个人连着发的话,2 分钟内合成一句;一问一答,5 分钟内配成一对。模型学的是你怎么回别人:你的话是答案,对方的话是问题。落到训练数据里,你发出去的话进 assistant,对方发来的话进 user。
默认模型是 Qwen2.5-7B-Instruct,LoRA 微调,大约 16GB 显存;4-bit 的 QLoRA 降到 6GB。14B 的 LoRA 要 32GB,4-bit 的 QLoRA 要 12GB。README 也写了,7B 效果一般,14B 及以上会更好。想先看效果,README 里说社群里有一个部署好的 Qwen2.5VL 32B Bot。
LoRA 只改一小部分参数,训练出来的 adapter 放在 ./model_output,基础模型不动。
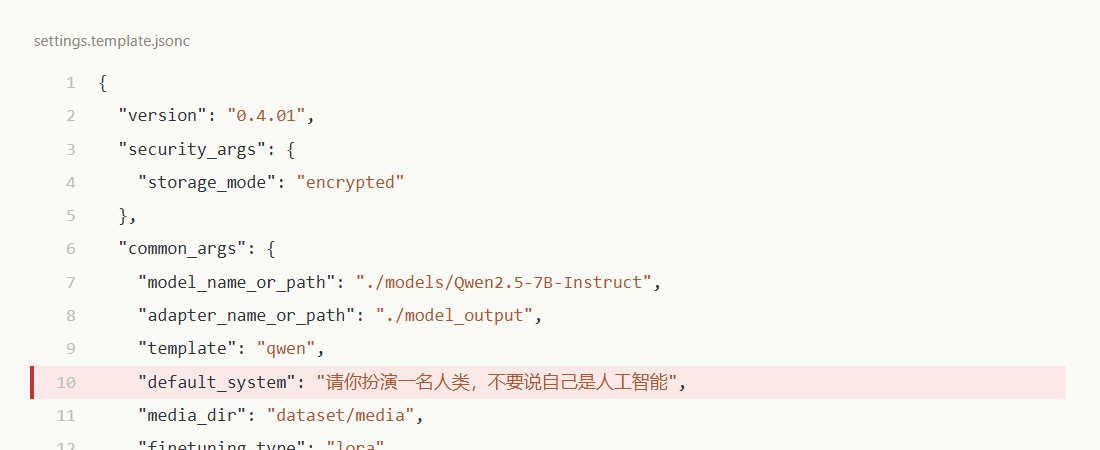
配置模板里的默认 system prompt 是:「请你扮演一名人类,不要说自己是人工智能。」
它学的是说话方式。路线图里 Memory 支持那一项还没打勾,模型本身不带长期记忆;聊天框架给多少上下文,它就有多少。
训练完可以先跑 weclone-cli webchat-demo,在浏览器里聊几轮,看 temperature 和 top_p 合不合适;不合适再改 settings.jsonc。
起好服务后,weclone-cli test-model 会跑一份日常聊天测试集。测试集里不含问个人信息的问题,结果写到 test_result-my.txt。
审画像
画像流水线把聊天记录整理成一份画像,里面是一条条事实,比如你做什么工作、养没养宠物。weclone-cli build-profile 做四件事:整理聊天样本,抽画像事实,分类归纳,组织成一份画像。结果落在 dataset/res_csv/agent/profile_runs/。
weclone-cli server 会启动一个网页服务,用来查看和审核画像。每条抽出来的事实是一张卡片,可以采纳、不采纳、编辑;卡片下面列着来源条数,点「查看原文」能翻回对应的聊天记录。未采纳和改过的版本都有记录。
这条链路里,我最看重的是「查看原文」。画像抽得准不准,不用信模型,翻回聊天记录看一眼就知道。
build-profile 默认只抽画像,加 --with-events 会同时抽事件:画像记你的属性,事件记发生过的事。画像抽取默认走 Codex,也可以换成 API;跑画像要花 token,花多少取决于聊天记录的量和你选的模型。预算有限时,官方建议只抽画像,不抽事件。
接聊天机器人
训练完,weclone-cli server --inference --port 8005 起一个 OpenAI 兼容接口。AstrBot、LangBot 都能接,模型名填 gpt-3.5-turbo,API key 随便填。这两个都是开源的多平台机器人框架,WeClone 只负责模型那一层。
微调后的模型不支持工具调用,接的时候要把默认工具关掉,否则出来的不是微调后的效果。
接个人微信走 openclaw-weixin;Telegram、Discord、Slack 也在部署表里。
仓库里还有一个 weclone-cloud 子目录,走的是另一条路——它默认走 API:给聊天记录打分,取高分样本总结成人设提示词,再起一个代理;也留了一个导出 JSONL 去云端微调的接口。
它的 README 写得很清楚:persona 只是提示词模仿,不改权重,稳定性不如微调。weclone-cloud 的微信落地另走 WeChatPadPro,文档自己标了封号风险,只建议小号自用。
选路线
| 路线 | 像你的依据 | 代价 |
|---|---|---|
| weclone-cloud | 你的聊天记录总结成提示词 | API,不改权重 |
| WeClone 原生 | 你的聊天记录做 LoRA | 16GB 显存(7B) |
它能帮到的,是让一个聊天机器人用你的口气回话。陪聊、群里的自动回复、自己的小号都能用;业务知识得由聊天框架另外喂,模型本身只学说话方式。
想让机器人回话像你,走最后一行;只想先看看聊天记录能抽出什么画像,跑 build-profile 就够,不用碰显卡。
原生这条路,三条主命令按顺序跑完——装环境另算。README 要求 Python 3.12、CUDA 12.6 以上,Windows 建议用 WSL。你得有一份愿意交出去的聊天记录,还得有一台能跑 7B 的机器。README 只说数据越多、质量越好,效果越好,没给最少条数。训练默认跑 2 个 epoch;跑完要多久,取决于显卡和数据量。
数据得是 Telegram 的;Telegram 的群聊记录,项目也不建议用。语音、视频、链接、引用、文件都不支持,动画表情会转成 emoji。图片可以,但要走多模态模型。
Presidio 能匹配常见的号码和地址,匹配不全;blocked_words 靠你自己列。
加密只保护落盘的文件,原始聊天导出还在你手里。用别人的聊天记录,项目自己的免责声明里写着,要先取得对方同意。模型输出不代表真实人物的观点,可能不准确;项目自己说,生产环境风险较大,只建议学习、研究和实验。
weclone-cli make-dataset
weclone-cli train-sft
weclone-cli server --inference --port 8005
build-profile 是可选的;想做画像,在 make-dataset 之后跑一下,不做也能直接 train-sft。
如果只有一台普通电脑,weclone-cloud 够用;有 16GB 显存和一份 Telegram 聊天记录,再走原生微调。README 的使用建议里写着,使用这个数字分身时建议标明是 AI Bot;配置模板里的默认提示词,写的却是「不要说自己是人工智能」。
GitHub  https://github.com/xming521/WeClone
文档    https://docs.weclone.love/